질문에 ChatGPT·Gemini 답과 Claude 분석을 합친 계획으로 답하는 스킬, llm-council
Claude Code에서 직접 실행한 기록입니다: 설치 방법, 필요한 API 키와 요금, 결과 카드 15장
gcpdev/llm-council-skill
스킬 스크립트가 질문을 OpenAI·Gemini API로 보내고, Claude가 두 답에 분석을 더해 누가 한 말인지 적은 글로 답합니다.
설치 방법
1. **Install the skill** in Claude by uploading the `llm-council.skill` file
2. **Set up API keys and model preferences**:
- Copy `.env.template` to create a `.env` file in your working directory
- Add your OpenAI API key (get it at https://platform.openai.com/api-keys)
- Add your Gemini API key (get it at https://aistudio.google.com/app/apikey)
- Optionally customize which models to use (see Model Options below)git clone --depth 1 https://github.com/gcpdev/llm-council-skill
mkdir -p .claude/skills && cp -R llm-council-skill/llm-council .claude/skills/llm-council
# .env 파일에 아래 세 줄(값은 직접 채움). OPENAI_MODEL은 README 기본 모델이 거절돼 바꾼 값
OPENAI_API_KEY=여기에_OpenAI_키
GEMINI_API_KEY=여기에_Gemini_키
OPENAI_MODEL=gpt-4.1-mini증가 신호로 뽑은 레포가 아니라 시험할 레포를 직접 지정한 것이라, 증가 신호는 약합니다. 2026-01-03에 만들어져(생성 291일) 누적 스타 478개·포크 62개이고, 최근 7일 새 포크는 2개, GitHub 트렌딩에는 없었으며 마지막 푸시는 2026-01-08입니다(7일 스타 증가량은 재지 못했습니다). 질문 13가지를 18번 실행해 15번 성공했고, 성공한 15번 모두 Claude의 최종 답이 모델별로 누가 한 말인지 적고 받아들이지 않은 제안은 이유를 적었습니다(시험자가 대조한 출처 표시 44곳은 맞았지만, run18에서 '두 모델이 짚지 않았다'고 한 부분은 실제로 모델 답에 있었습니다). 다만 README 기본 OpenAI 모델이 이 스크립트에서 거절돼 .env 설정을 바꿔야 ChatGPT 답을 받았고(기본 설정으로 한 run04·run05는 Gemini만 답했습니다), 키와 요금은 쓰는 사람 몫이며 키가 오류 문장에 섞일 수 있습니다(아래 '써 보니').
필요 조건
- Claude Code(시험 2.1.304)와 스킬 폴더 .claude/skills/llm-council/
- python3 + requests 패키지(시험: Python 3.12.3, requests 2.31.0 시스템 패키지)
- OpenAI API 키와 Gemini API 키(유료 API 사용량, 요금은 키 주인 계정). 작업 폴더의 .env에 둔다
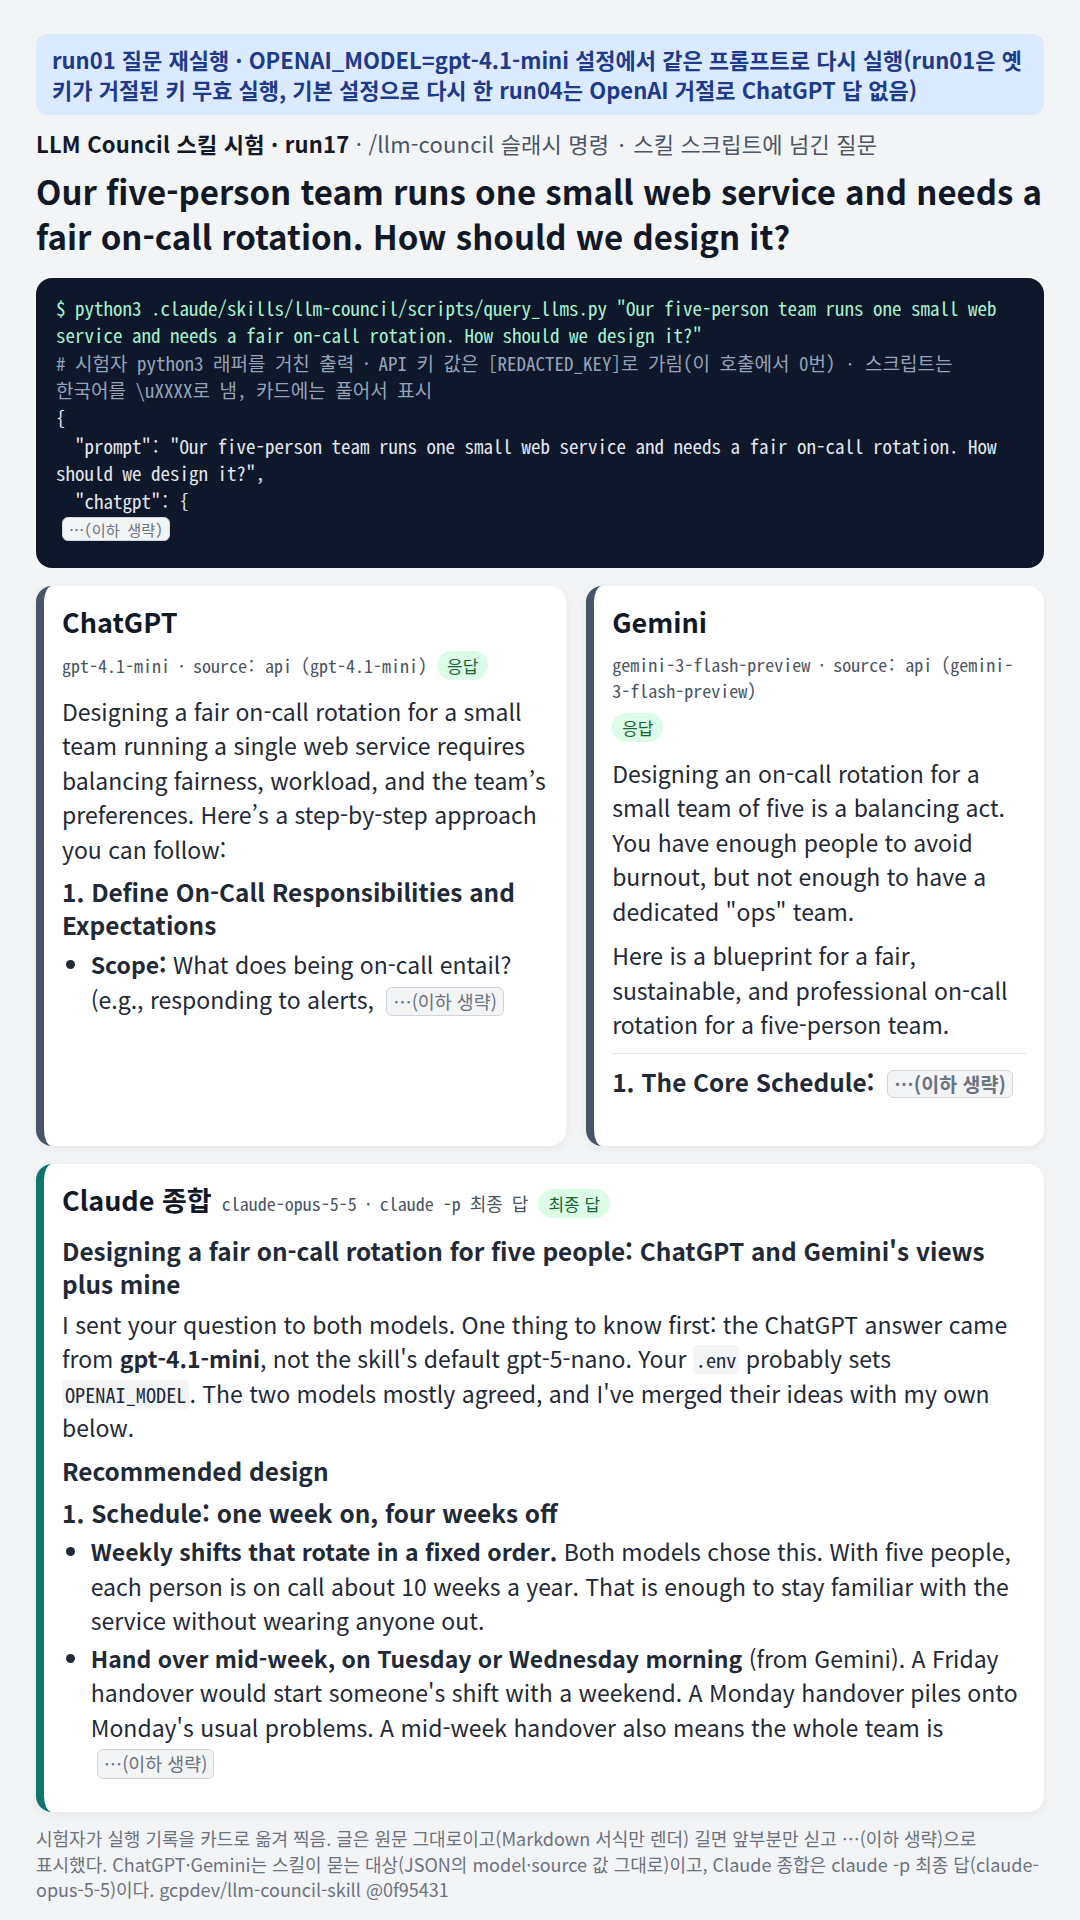
- OpenAI 모델: 기본값 gpt-5-nano는 이 스크립트로 답을 받지 못했다(400 unsupported_parameter: max_tokens). 시험은 .env에 OPENAI_MODEL=gpt-4.1-mini를 넣어 답을 받았다(README 목록 밖 모델)
- 인터넷: api.openai.com, generativelanguage.googleapis.com(질문 전문이 전송된다)
시험할 때 실제로 실행한 명령
# $T = 시험용 작업 폴더(전체 경로는 생략)
git clone --depth 1 https://github.com/gcpdev/llm-council-skill $T/src (커밋 0f95431, 2026-01-08)
실행마다 새 샌드박스 $SB=/tmp/gitstar-sandbox/gcpdev__llm-council-skill/runNN: mkdir -p $SB/.claude/skills && cp -R $T/src/llm-council $SB/.claude/skills/llm-council (tools/mk_sandbox.sh)
키: 프로젝트 .env에서 OPENAI_API_KEY·GEMINI_API_KEY 두 줄만 $SB/.env(권한 600)로 복사(tools/put_env.py, 값 출력 없음). run06부터 OPENAI_MODEL=gpt-4.1-mini 줄 하나 추가(tools/model_config.env). run03은 .env 없이
cd $SB && PATH=$SB/.bin:$PATH claude -p "/llm-council <질문>…" --output-format json --tools Bash,Read,Glob --permission-mode dontAsk --allowedTools "Bash(python3:*)" "Bash(ls:*)" Read Glob --disallowedTools <.env 읽기·하네스 폴더 읽기·내용 출력 셸 명령·네트워크·설치 명령 등 79개> --strict-mcp-config --no-chrome --max-budget-usd 2 (run_once.py, tools/trial.sh·claude_flags.sh)
자연어 호출(run14·run15): 프롬프트 첫머리 'Consult the council: …', --tools·--allowedTools에 Skill 추가
$SB/.bin: python3 래퍼(이 스킬의 scripts/query_llms.py 실행만 진짜 python3로 넘기고 출력에서 두 키 값을 [REDACTED_KEY]로 가림), codex·gemini 심(호출만 기록하고 종료 코드 1 → 스크립트는 API로 넘어감), curl·wget·npm·npx·pip·uv 막이
실행이 끝나면 rm -f $SB/.env보안 검토: caution — 훅·MCP·플러그인 구조 없음, 난독화·원격 실행 없음. scripts/query_llms.py가 작업 폴더 .env의 두 API 키로 OpenAI(키는 헤더)·Gemini(키는 URL 쿼리) API에 질문 전문을 보낸다(외부 전송·요금). Gemini HTTP 오류 때 키가 든 주소가 출력에 찍히는 경로가 있다(가짜 키로 재현, 시험 중 실제 2번 → 래퍼가 가림). PATH의 codex·gemini CLI를 먼저 부른다(codex-cli 0.161·0.163에서 -p는 --profile). 시험은 키 두 줄만 샌드박스 .env로 복사, 모델의 .env 읽기 차단, python3 래퍼로 출력 속 키 가림, codex·gemini 심으로 사용자 로그인 미사용(security_review.md)
써 보니
- OpenAI 기본 모델이 거절됩니다: README가 기본으로 적은 gpt-5-nano는 이 스크립트가 보내는 max_tokens를 OpenAI가 400 오류(unsupported_parameter, 'max_completion_tokens를 쓰라'는 안내)로 거절해 답을 받지 못했습니다(기본 설정으로 한 run04·run05). 스크립트는 OpenAI 오류의 사유를 버리고 '400 Client Error: Bad Request'만 남겨서 출력만 봐서는 원인을 알 수 없습니다. run04의 Claude는 .env의 OPENAI_MODEL을 바꿔 보라고 권했고(예로 든 gpt-5-mini는 시험하지 않았으며, gpt-5 계열은 같은 매개변수 문제가 있을 수 있습니다), run05의 Claude는 스킬 스크립트를 직접 읽고 max_tokens가 원인일 수 있다고 짚었습니다. .env에 OPENAI_MODEL=gpt-4.1-mini(README 모델 목록에 없는 모델)를 넣자 run06부터 13번 모두 두 모델이 답했습니다. Gemini는 기본값 gemini-3-flash-preview로 15번 모두 정상이었고(생각 토큰 456~764개와 답 852~1,239개를 합쳐 최대 1,902개로 출력 상한 2,000개 안), 잘림 오류는 없었습니다.
- 키와 요금: OpenAI API 키와 Gemini API 키가 필요하고 작업 폴더의 .env에 둡니다. 질문 전문이 OpenAI와 Google 서버로 전송되고 요금은 키 주인의 API 계정에서 나갑니다. 이번 시험의 외부 호출은 OpenAI 17번(거절·오류 포함)과 Gemini 17번이었고, 응답 200을 받은 호출의 토큰 합계는 OpenAI 입력 788·출력 10,052개, Gemini 입력 722·답 16,029·생각 9,246개였습니다. 달러 금액은 재지 않았습니다(아래 비용은 Claude 쪽입니다).
- 키가 오류 문장에 섞일 수 있습니다: 스크립트는 Gemini 키를 요청 주소의 ?key= 뒤에 실어 보냅니다. 그래서 Gemini 호출이 HTTP 오류나 연결 오류로 끝나면 키가 든 주소가 오류 문장에 들어가 스크립트 출력에 찍히고, 그 출력은 Claude 대화에 그대로 들어갑니다(가짜 키와 닫힌 프록시로 재현했습니다). 시험에서는 옛 키가 무효였던 run01·run02에서 실제로 2번 찍혔고, 시험자가 스크립트 앞에 세운 래퍼가 키를 [REDACTED_KEY]로 가려서 기록에는 남지 않았습니다. 그 뒤 실행(run03~run18)에서는 0번이었고, 끝난 뒤 시험 기록과 Claude Code 세션 기록에서 실제 키 값을 찾았으나 0번이었습니다. 가림 장치 없이 쓰면 오류가 났을 때 키가 든 주소가 대화와 세션 기록에 남을 수 있으니, 오류 문장에 키가 보이면 그 키는 노출된 것으로 보고 새로 발급하세요. 또 스크립트는 작업 폴더의 .env에서 키 두 개와 모델 두 개의 이름만 읽지만, 다른 비밀 값이 든 .env가 있는 폴더에서 쓰면 그 파일이 모델의 작업 폴더에 놓입니다(시험에서는 .env를 권한 600으로 두고 모델이 읽지 못하게 막았으며, 실행이 끝나면 지웠습니다. 막지 않은 상태는 시험하지 않았습니다).
- 스크립트가 먼저 부르는 명령: PATH에 codex나 gemini 명령이 있으면 API보다 먼저 'codex -p <질문>'·'gemini -p <질문>'을 실행하고(각 60초 제한), 종료 코드가 0이면 그 출력을 답으로 씁니다. Codex CLI에서 -p는 질문이 아니라 프로필 옵션입니다(0.161.0·0.163.0에서 확인). 자격 증명이 없는 빈 HOME·터미널 없음 조건에서 codex -p는 두 버전 모두 0.3초 안에 종료 코드 1('stdin is not a terminal' 등)로 끝났습니다. 시험 실행에서는 두 명령을 호출만 기록하고 실패로 돌려주는 가짜 명령으로 바꿔 두어(진짜 실행 0번, 시험자의 로그인은 쓰지 않음) 스크립트가 API로 넘어갔습니다. 로그인된 codex가 있는 상태의 동작과 gemini 명령은 시험하지 않았습니다.
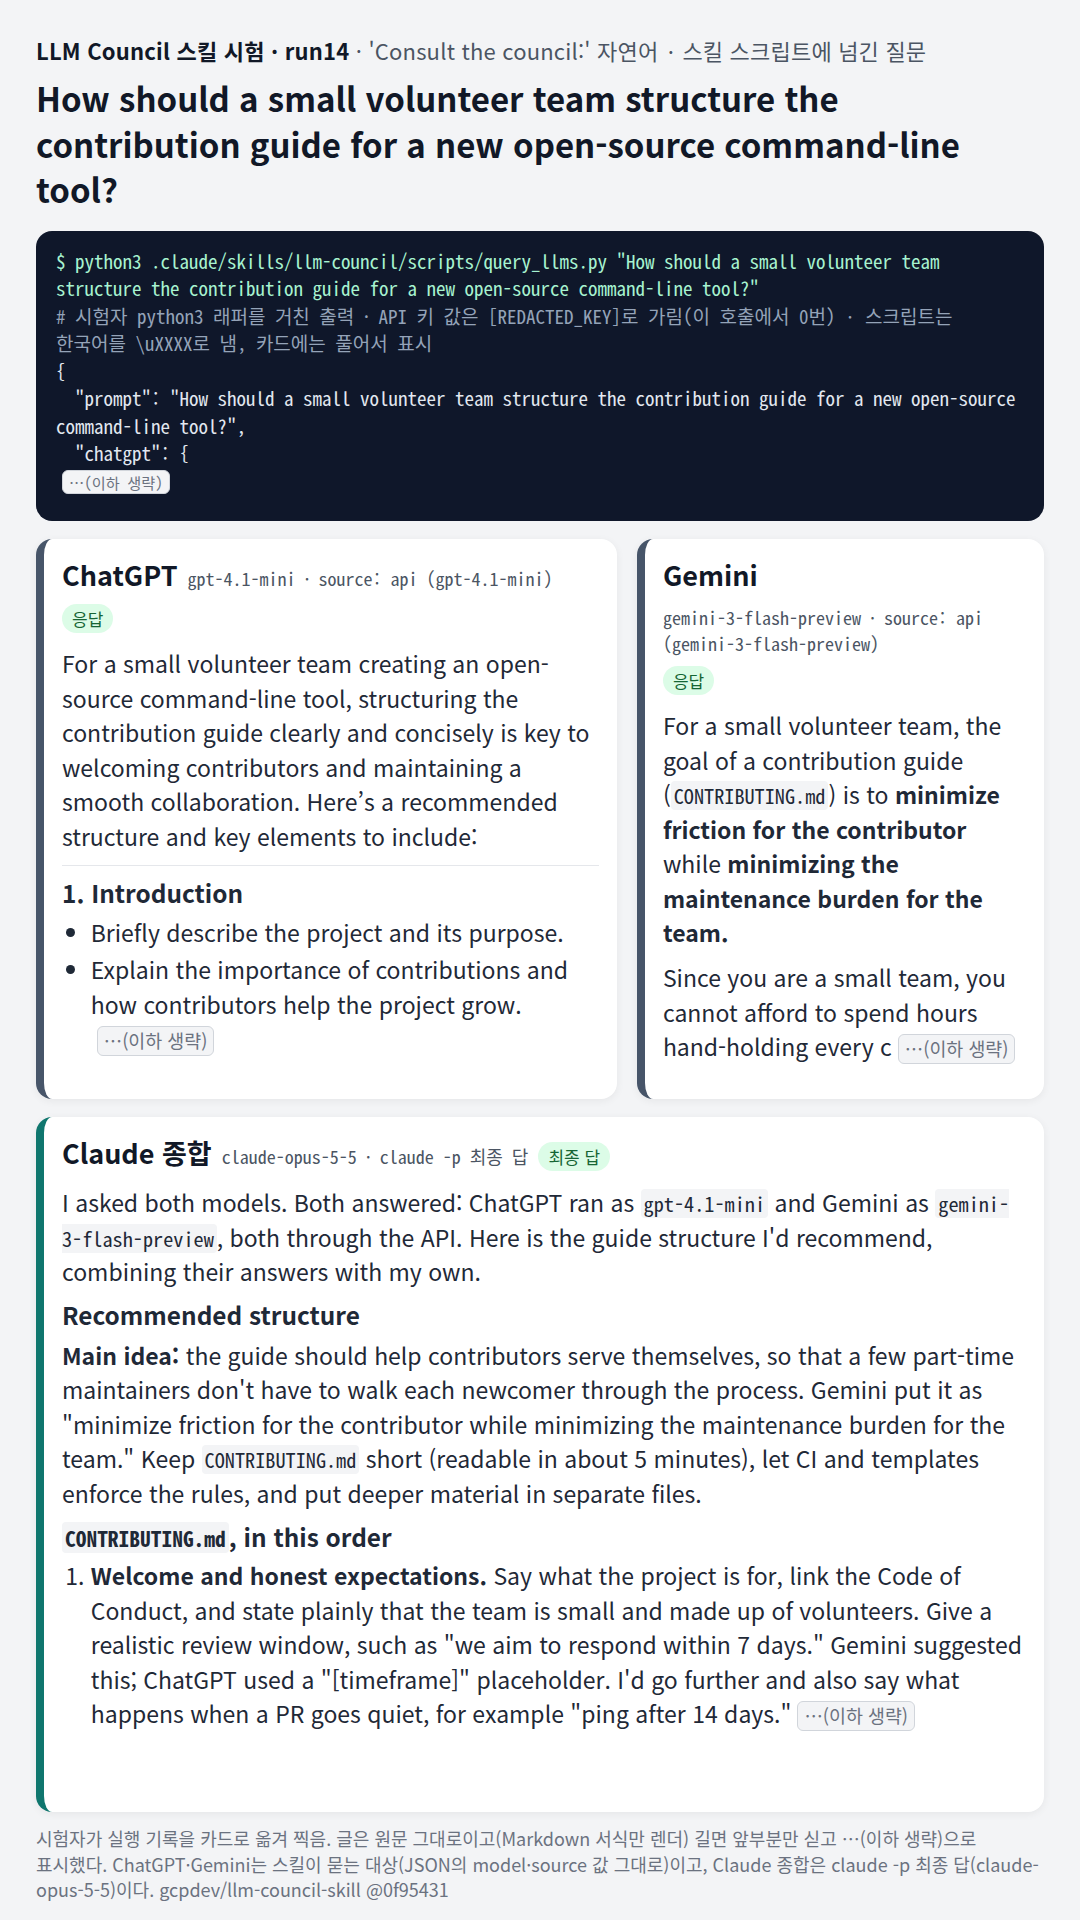
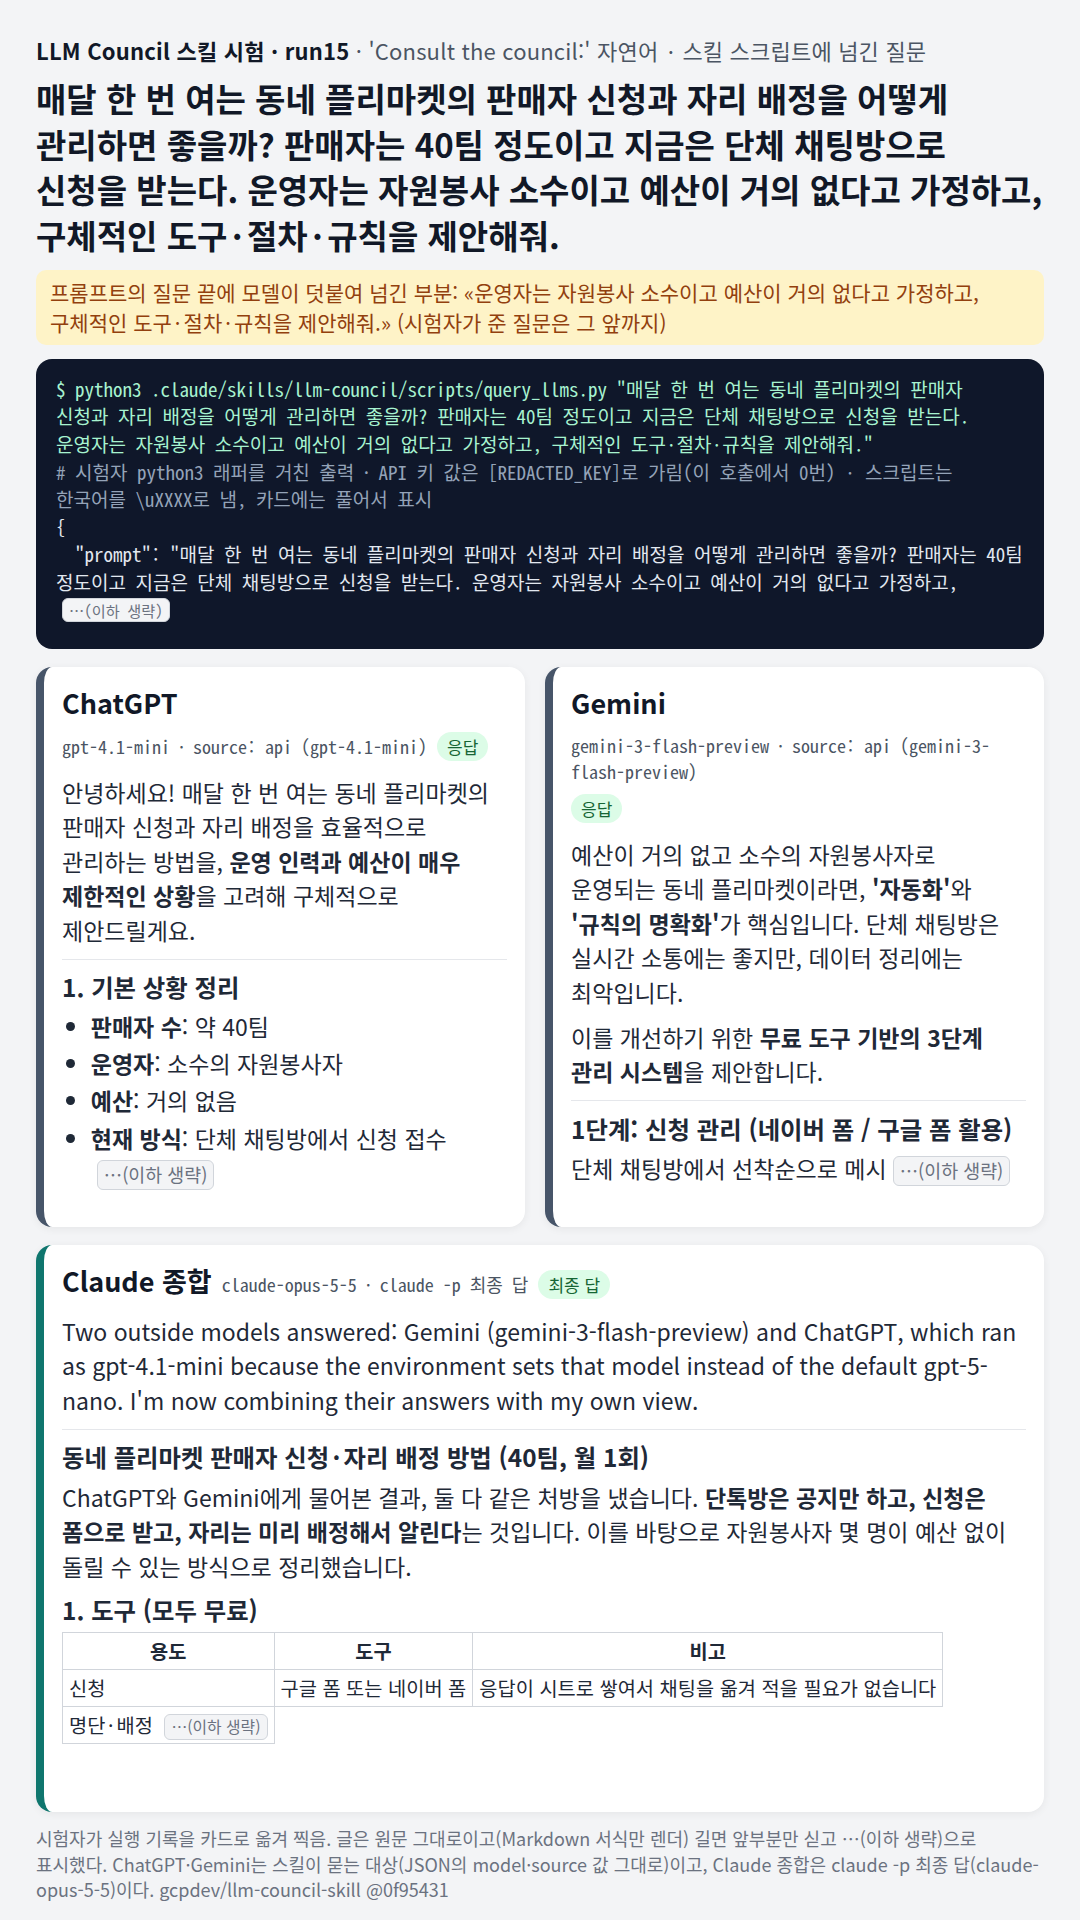
- 부르는 법: 스킬 폴더를 둔 프로젝트에서 /llm-council 다음에 질문을 적어 16번 불렀고(성공 13번), README 예시 꼴인 'Consult the council: 질문' 문장만 쓴 2번(run14 영어, run15 한국어)도 모델이 스스로 이 스킬을 불렀습니다(시험 설정에서 Skill 도구를 허용했고, 대화형 세션은 시험하지 않았습니다). SKILL.md의 설명문은 ChatGPT·Gemini 같은 여러 AI 모델에게 의견을 구하겠다고 분명히 요청할 때 쓰라고 적고 있습니다. README의 비용 설명에 나오는 /council 명령은 불러 보지 않았습니다. 질문은 한국어 11개(39~129자)와 영어 2개(107자)였습니다. 모델이 스크립트에 넘긴 질문은 18번 중 17번이 시험자가 쓴 질문과 같았고, 달랐던 run15는 모델이 끝에 '운영자는 자원봉사 소수이고 예산이 거의 없다고 가정하고, 구체적인 도구·절차·규칙을 제안해줘.'를 덧붙였습니다(시험자가 시킨 것이 아니고 카드의 노란 칸에 표시했으며, 이 문장도 OpenAI·Google로 전송됐습니다).
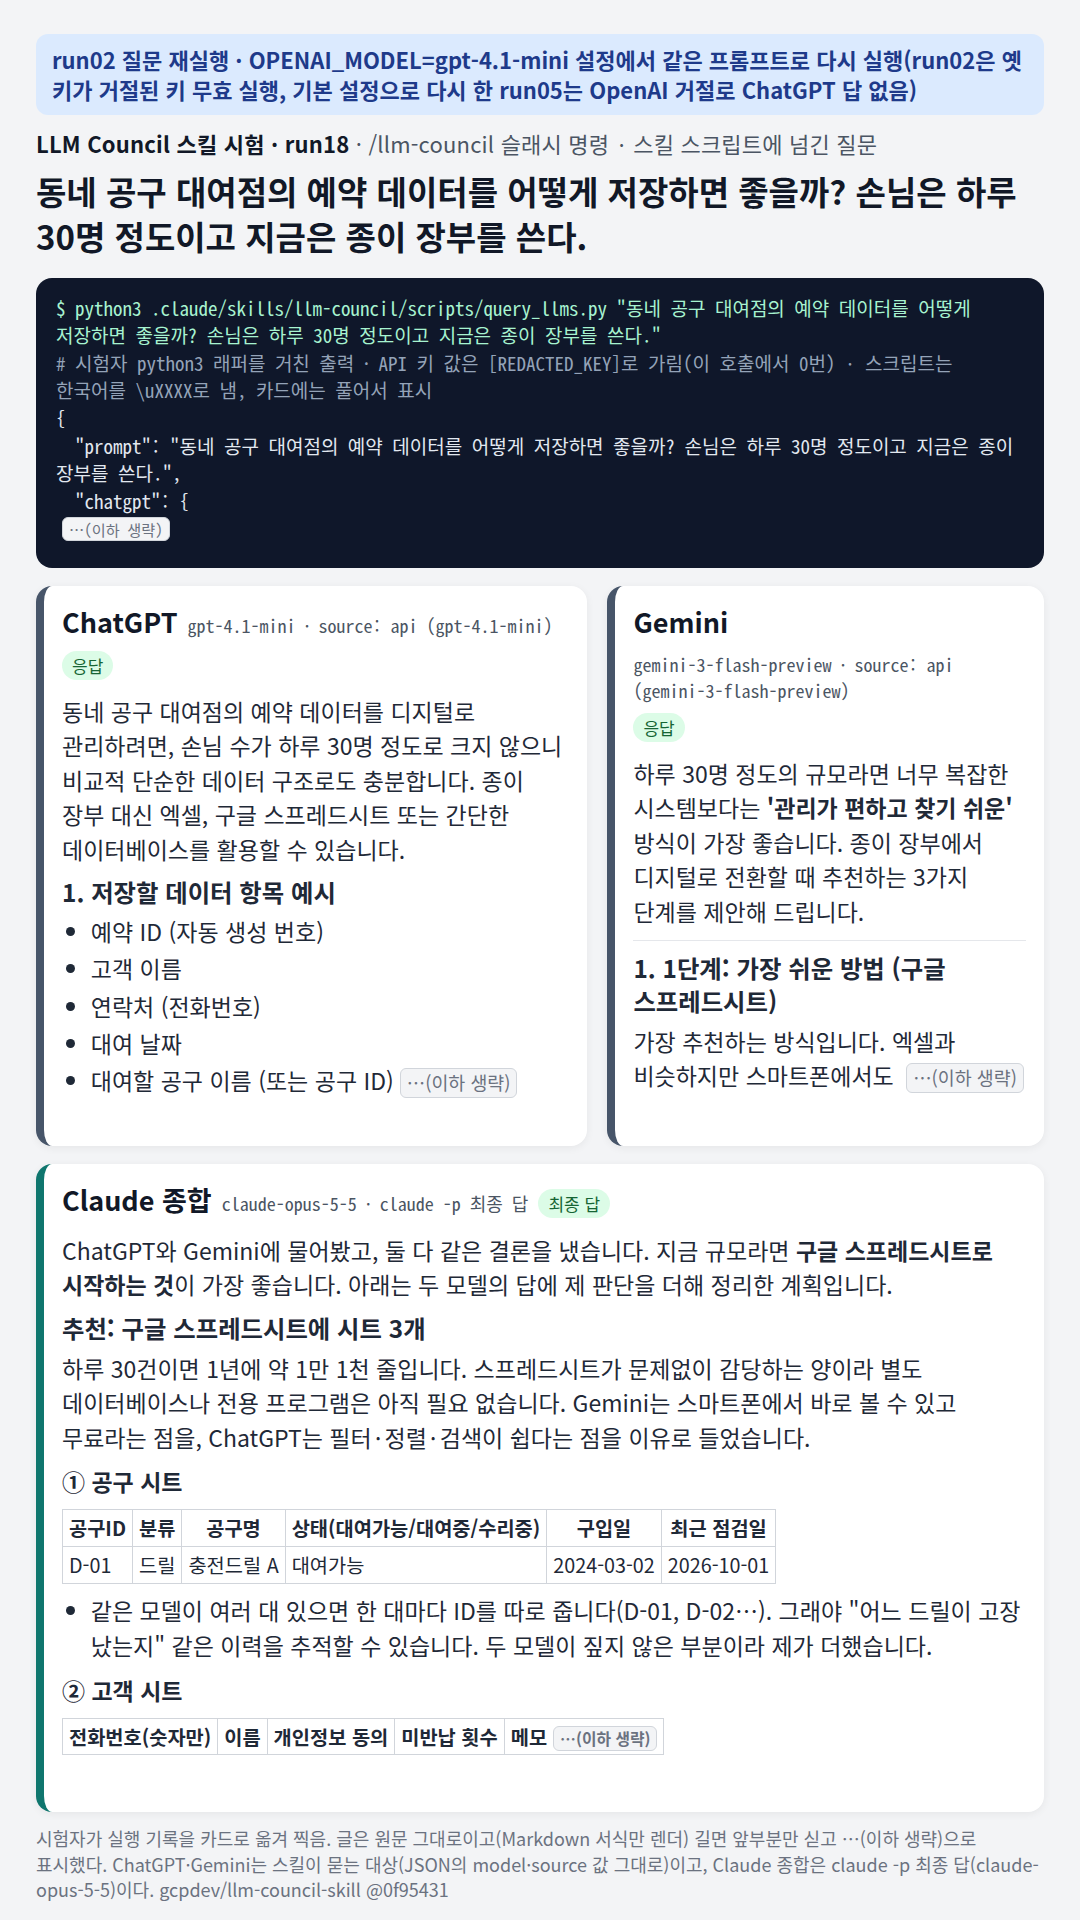
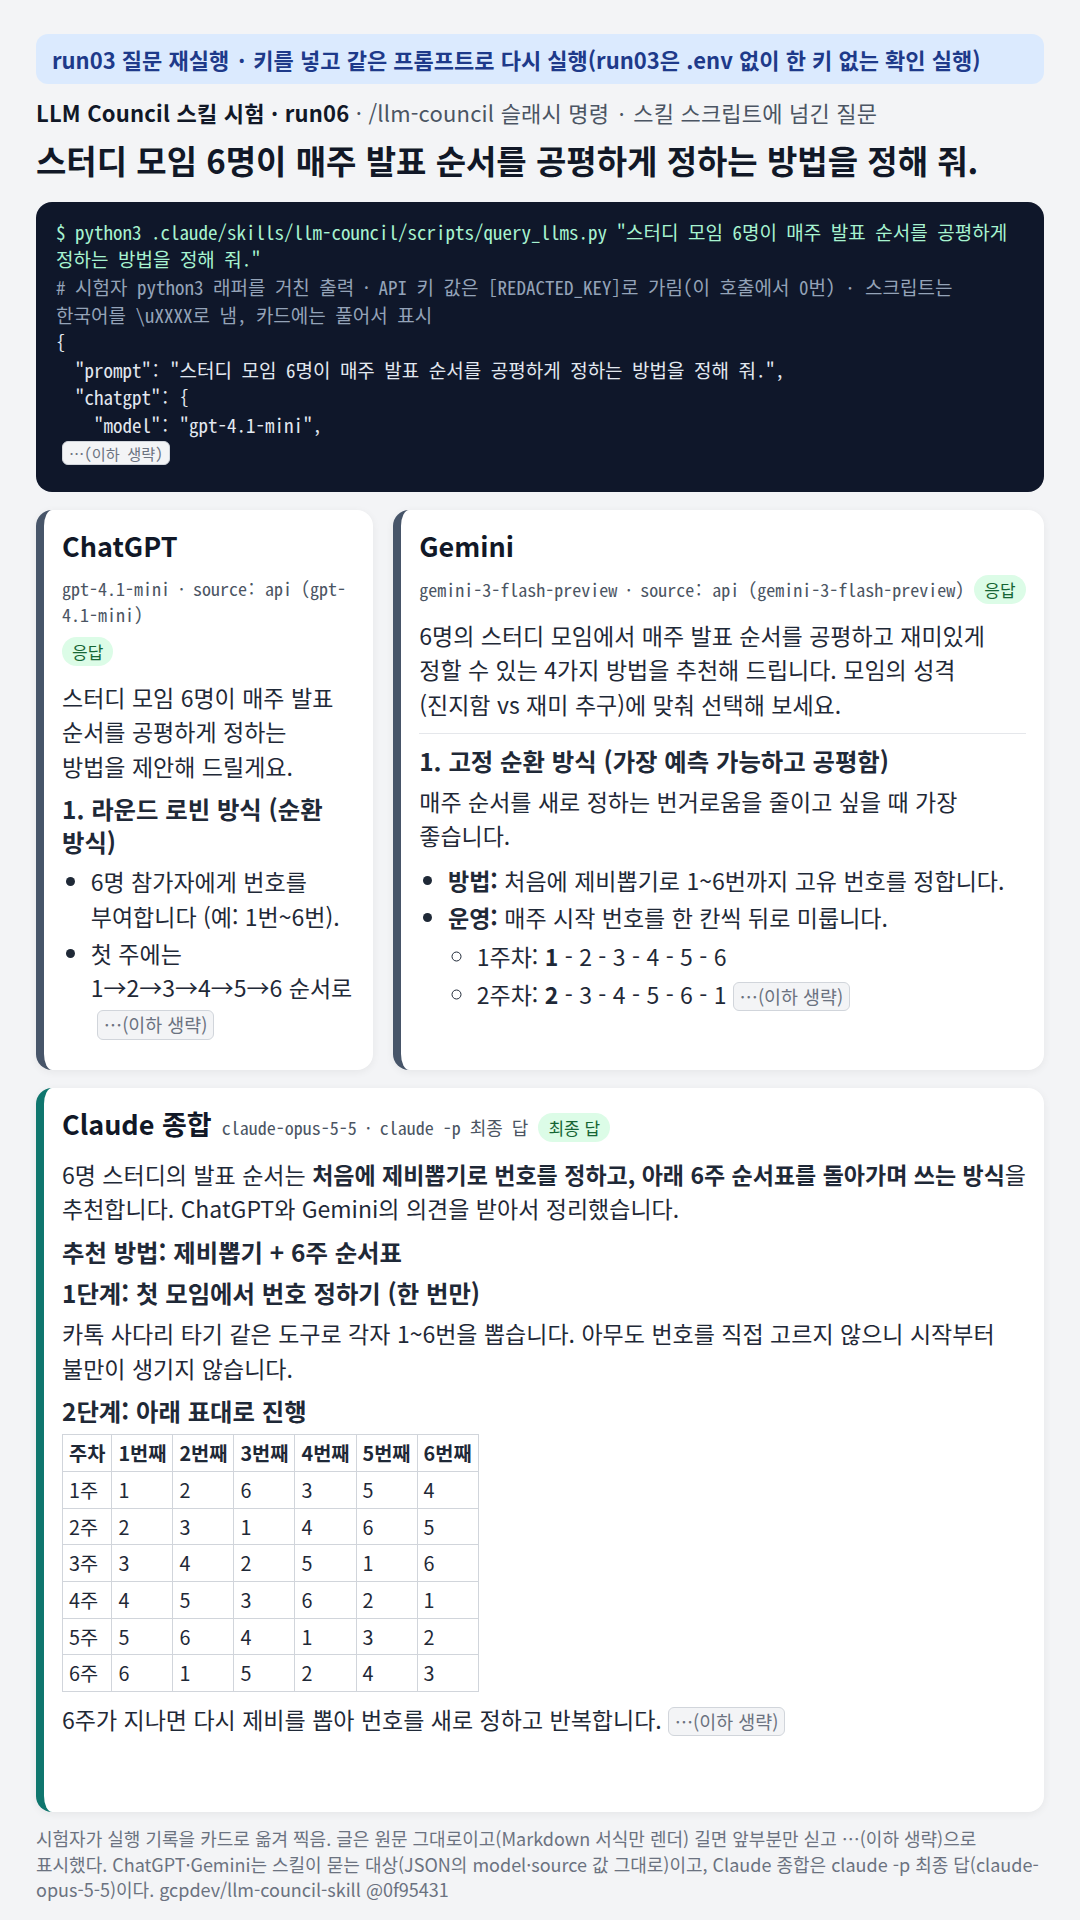
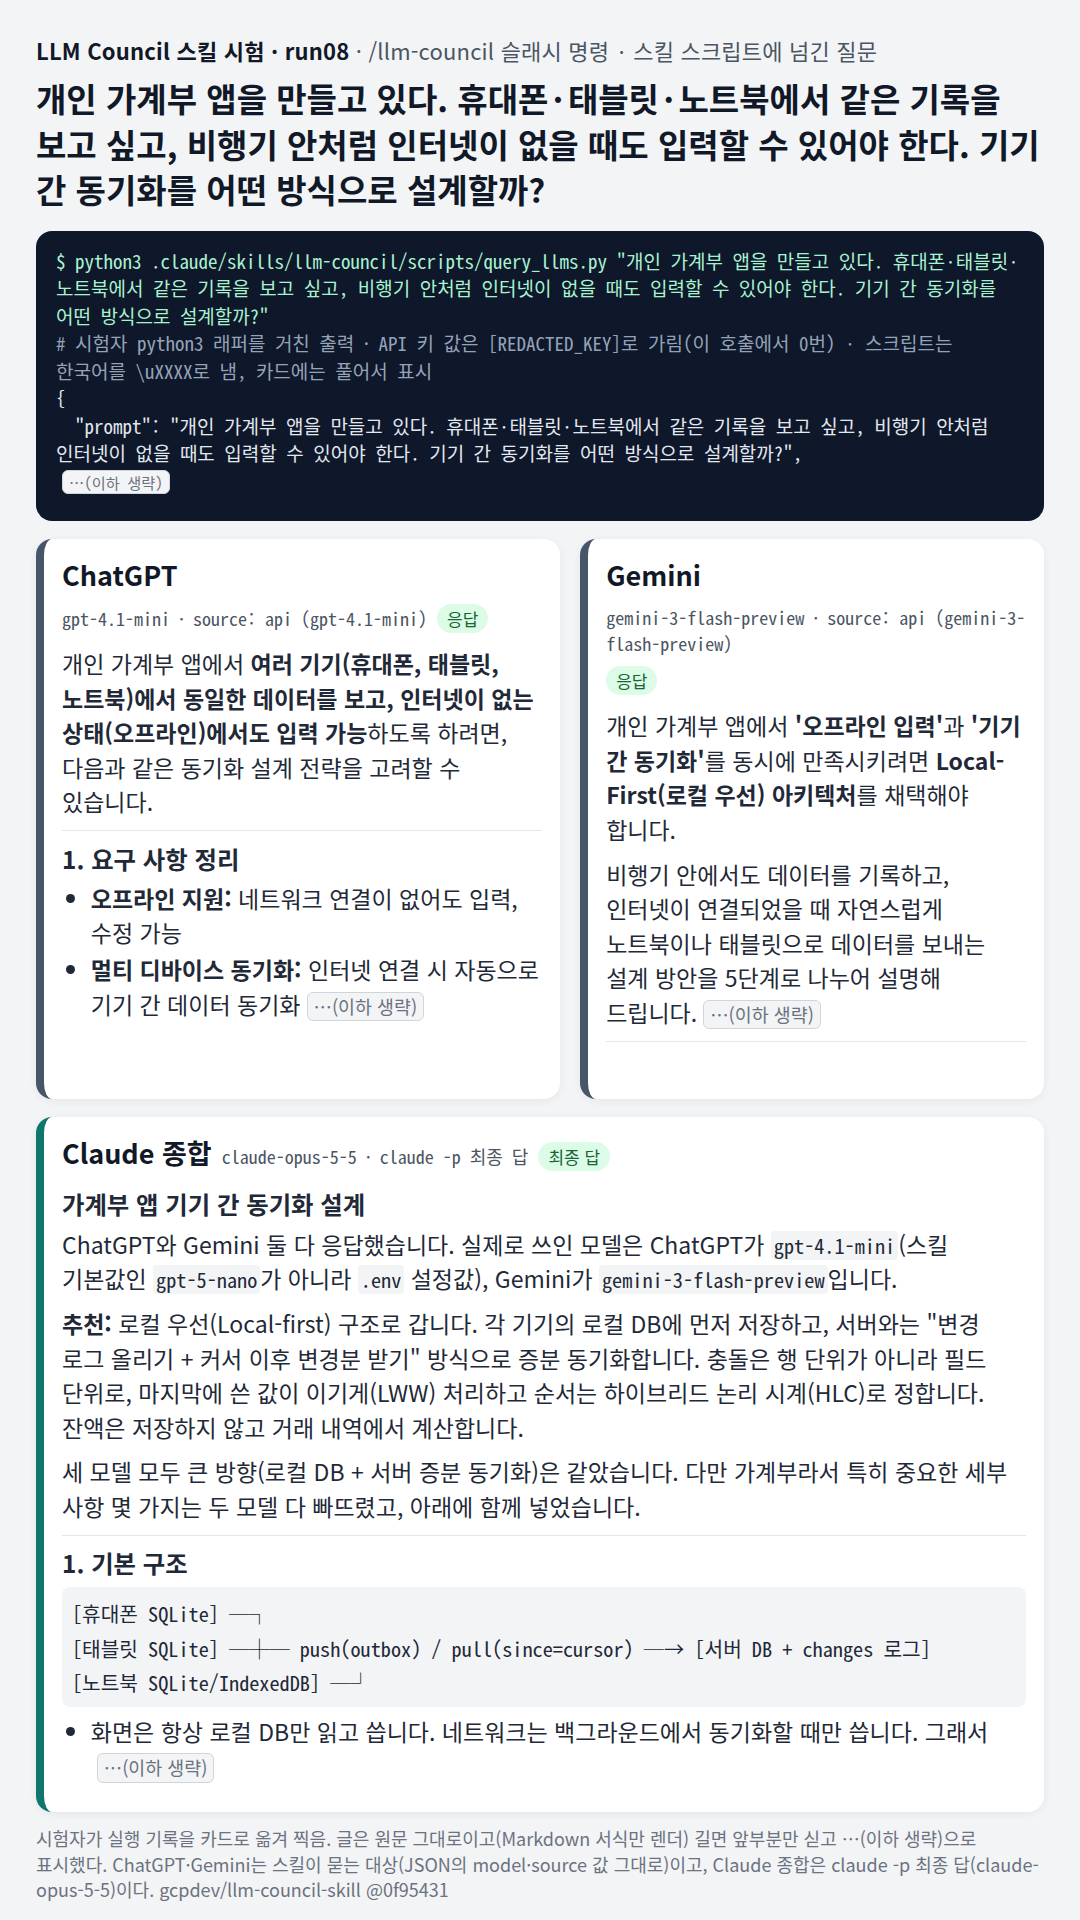
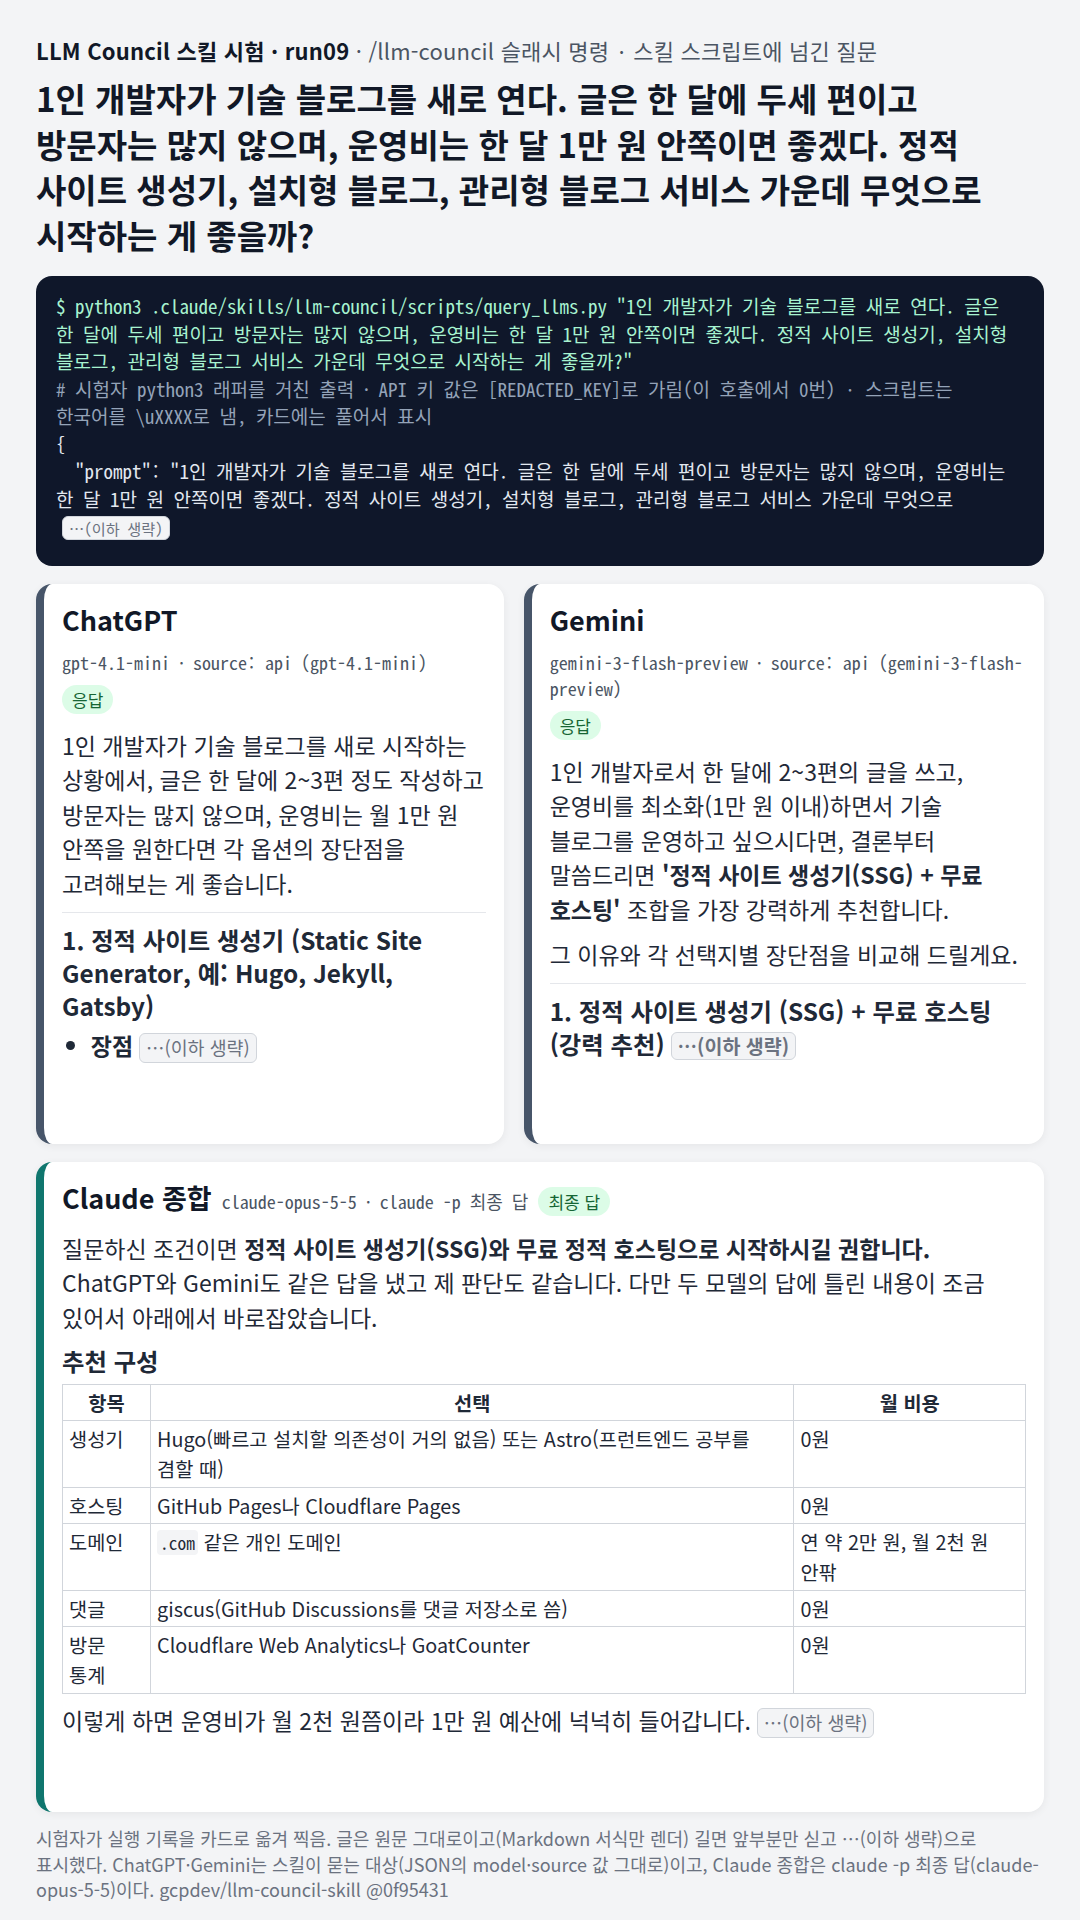
- 결과는 채팅 글입니다: Claude의 최종 답은 1,592~4,887자이고, 두 모델이 답한 13번 중 12번(run14 제외)에서 ChatGPT 답이 문서의 기본값 gpt-5-nano가 아니라 gpt-4.1-mini에서 왔다고 스스로 밝혔습니다(스크립트 출력에 모델 이름이 찍히기 때문입니다). 두 답을 이어 붙이지 않고 고르거나 고쳤습니다. run06은 두 답이 모두 한 칸씩 미는 순환을 권했는데 Claude가 앞뒤 사람이 늘 같아지는 문제를 짚어 6주 순서표로 바꿨고(시험자가 표를 확인했습니다: 6주 동안 각 자리와 각 바로 앞사람이 한 번씩 나옵니다), run08은 Gemini의 행 단위 덮어쓰기를 필드 단위로 바꾸고 ChatGPT가 선택지로 든 CRDT는 이 앱에 과하다고 봤고, run17은 백업 담당을 두자는 ChatGPT와 5명 중 둘을 묶으면 팀의 40%라는 Gemini의 의견 사이에서 다음 주 담당이 가볍게 백업을 맡는 쪽으로 절충했습니다.
- 출처 표시는 대체로 맞았지만 요약이 원문보다 단순하거나 틀린 곳도 있었습니다: 시험자가 run04·06·07·09·10·11·14~18의 최종 답에서 출처 표시 44곳을 원 응답과 대조했고 모두 맞았습니다(철자·띄어쓰기 차이 2곳). 다만 run18의 Claude는 공구 한 대마다 ID를 따로 주는 것을 '두 모델이 짚지 않은 부분이라 제가 더했습니다'라고 썼는데, ChatGPT 답에는 '공구 ID'가, Gemini 답에는 공구 '고유번호'·'관리번호(ID)'가 이미 들어 있었습니다(같은 모델이 여러 대면 한 대씩 나누라는 말까지는 없었습니다). run16의 Claude는 푸시 알림을 'ChatGPT는 알림을 필수 기능의 예로 들었고 Gemini는 빼라고 했습니다'라고 정리했는데(위 대조에서는 맞는 것으로 셌습니다), ChatGPT 원문에는 두 대목이 있습니다. 앞 대목은 '실제 사용자(동네 소모임 멤버 등)가 꼭 필요로 하는 기능이 무엇인지 … 예를 들어, … 알림 기능 등이 될 수 있습니다'이고, 뒤 대목은 자기 '필수 기능(우선 포함)' 목록(일정 등록, 일정 조회, 참석자 확인)에 알림을 넣지 않고 '자동 리마인더'를 '부가 기능(추후 추가)'에 둔 것입니다. Claude의 정리는 앞 대목과는 맞고 뒤 목록과는 어긋나서, 입장이 정반대라고 하기는 어렵습니다. 모델별 기여를 적어 준 글을 그대로 믿기보다, 중요한 곳은 스크립트 출력(원 응답)과 맞춰 보세요.
- 실패했을 때: 옛 키가 무효였던 run01·run02는 OpenAI 401·Gemini 400이 나왔고, Claude가 첫 문장에서 두 모델 모두 답하지 못했다고 밝힌 뒤 오류 코드와 추정 원인을 적고 혼자 분석한 안을 냈습니다(run02는 .env를 열 수 없어서 원인은 확인하지 못했다고 밝혔습니다). .env가 없던 run03은 스크립트가 'API_KEY not found' 오류를 냈고 Claude가 .env를 만드는 법을 안내한 뒤 혼자 6주 발표 순서표를 냈습니다. 한쪽만 실패한 run04·run05도 첫 문장에서 어느 모델이 답하지 못했는지 밝혔습니다. 스크립트는 두 API가 모두 실패해도 종료 코드 0으로 끝나서, 실패는 출력 JSON의 response가 'Error …'로 시작하는 것으로만 알 수 있습니다.
- 시험 제한: 모델이 쓸 수 있는 도구를 Bash(python3와 ls만)·Read·Glob으로 줄였고 웹 검색과 파일 쓰기는 막았습니다(자연어 호출 2번은 Skill 도구 추가). 그래서 모델 답 속 사실은 확인하지 못했고(run08의 Claude는 웹 검색이 막혀 현재 상태를 확인하지 못했으니 고르기 전에 확인하라고 적었고, run11은 ChatGPT가 든 앱 이름이 실제로 있는지 확인하지 못했다고 밝혔습니다), 웹 검색을 허용한 환경에서는 달라질 수 있습니다. 권한·셸 안전 검사로 실행 전에 막힌 호출은 18번 중 2번(run14·run15 각 1번)이었고, 둘 다 명령 여러 개를 이은 복합 명령이었습니다(run15의 것은 .env의 키 이름을 보려던 명령이 들어 있었습니다). 그 밖의 도구 오류는 0번이었습니다. 모델이 스크립트 파일을 직접 읽은 실행은 5번(run05·10·13·14·15)이었습니다.
- 비용·시간(Claude 쪽): 시험은 claude-opus-5-5, Claude Code 2.1.304로 2026-10-22 22:02~23:11에 했고 실행은 최대 2개씩 동시에 돌렸습니다. 성공한 실행 하나에 39.1~90.1초(평균 59초), 0.09~0.36달러가 들었고 18번 합계는 3.37달러(성공 15번 3.09달러)이며, 비용 상한(--max-budget-usd 2)에 걸린 실행은 없었습니다. 이 시간 중 스크립트가 두 모델에 묻고 기다린 시간은 10.3~20.0초였습니다.
- 스킬 폴더와 README 설치(방법 1): 스킬 폴더 llm-council/은 SKILL.md, scripts/query_llms.py(212줄), references/SETUP.md, .env.template 4개 파일입니다(훅·MCP 서버·난독화 없음, 시험 전에 모두 읽었습니다). Claude.ai에 올리는 llm-council.skill(6,188바이트)은 풀지 않고 내용만 폴더와 비교했습니다. 안에 llm-council/ 폴더가 없이 파일 4개가 평면으로 들어 있고 하위 경로 구분자가 백슬래시(references\SETUP.md, scripts\query_llms.py)이며, 내용은 폴더와 같습니다(SETUP.md·query_llms.py는 바이트까지 같고 SKILL.md·.env.template은 줄바꿈 방식만 다릅니다). 레포의 이슈 #1에 이 파일 업로드 실패 보고가 있습니다(시험 전 조사에서 본 것이고 이 시험에서는 확인하지 않았습니다).
- 시험하지 않은 것: Claude.ai에 .skill 파일 올리기(README 방법), README 목록의 다른 OpenAI 모델(gpt-5-mini·gpt-5.2·gpt-5.2-pro)과 Gemini의 다른 모델, 로그인된 codex·gemini 명령을 거치는 경로, 대화형 세션(승인 창 등), 두 키 중 하나만 있는 경우, 모델 답의 내용이 맞는지 따져 보는 일입니다(run06의 순서표만 확인했고, run18이 낸 중복 예약 수식 COUNTIFS도 스프레드시트에서 실행해 보지 않았습니다).
- 이름·출처·라이선스: 이 레포(gcpdev/llm-council-skill)는 이름이 같은 다른 프로젝트들(예: karpathy/llm-council)과 별개입니다. 이 페이지는 레포를 만든 gcpdev가 아니라 시험자가 직접 돌려 본 기록이고, 결과 카드 PNG만 싣고 스킬 문서와 스크립트는 싣지 않았습니다. 레포는 MIT 라이선스입니다.
결과물 15개
프롬프트 전문 보기
프롬프트 전문 보기
프롬프트 전문 보기
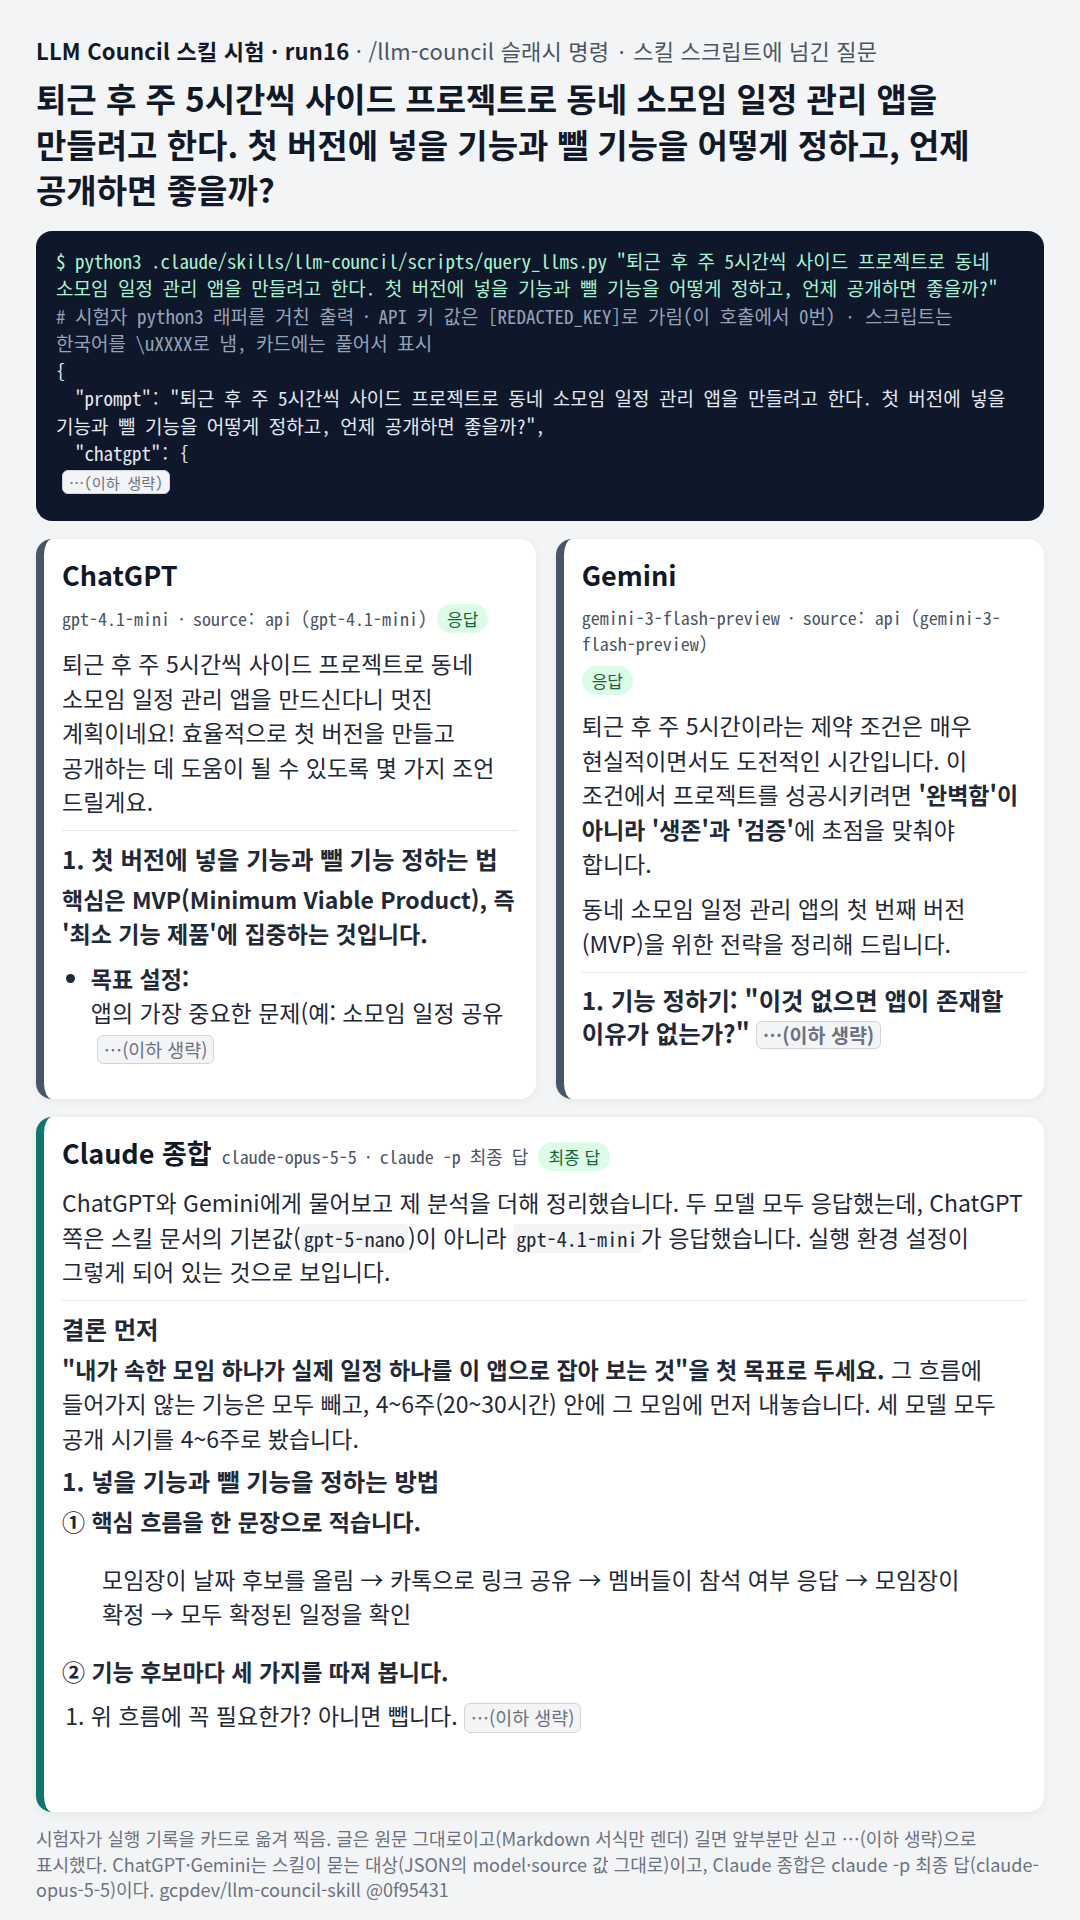
프롬프트 전문 보기
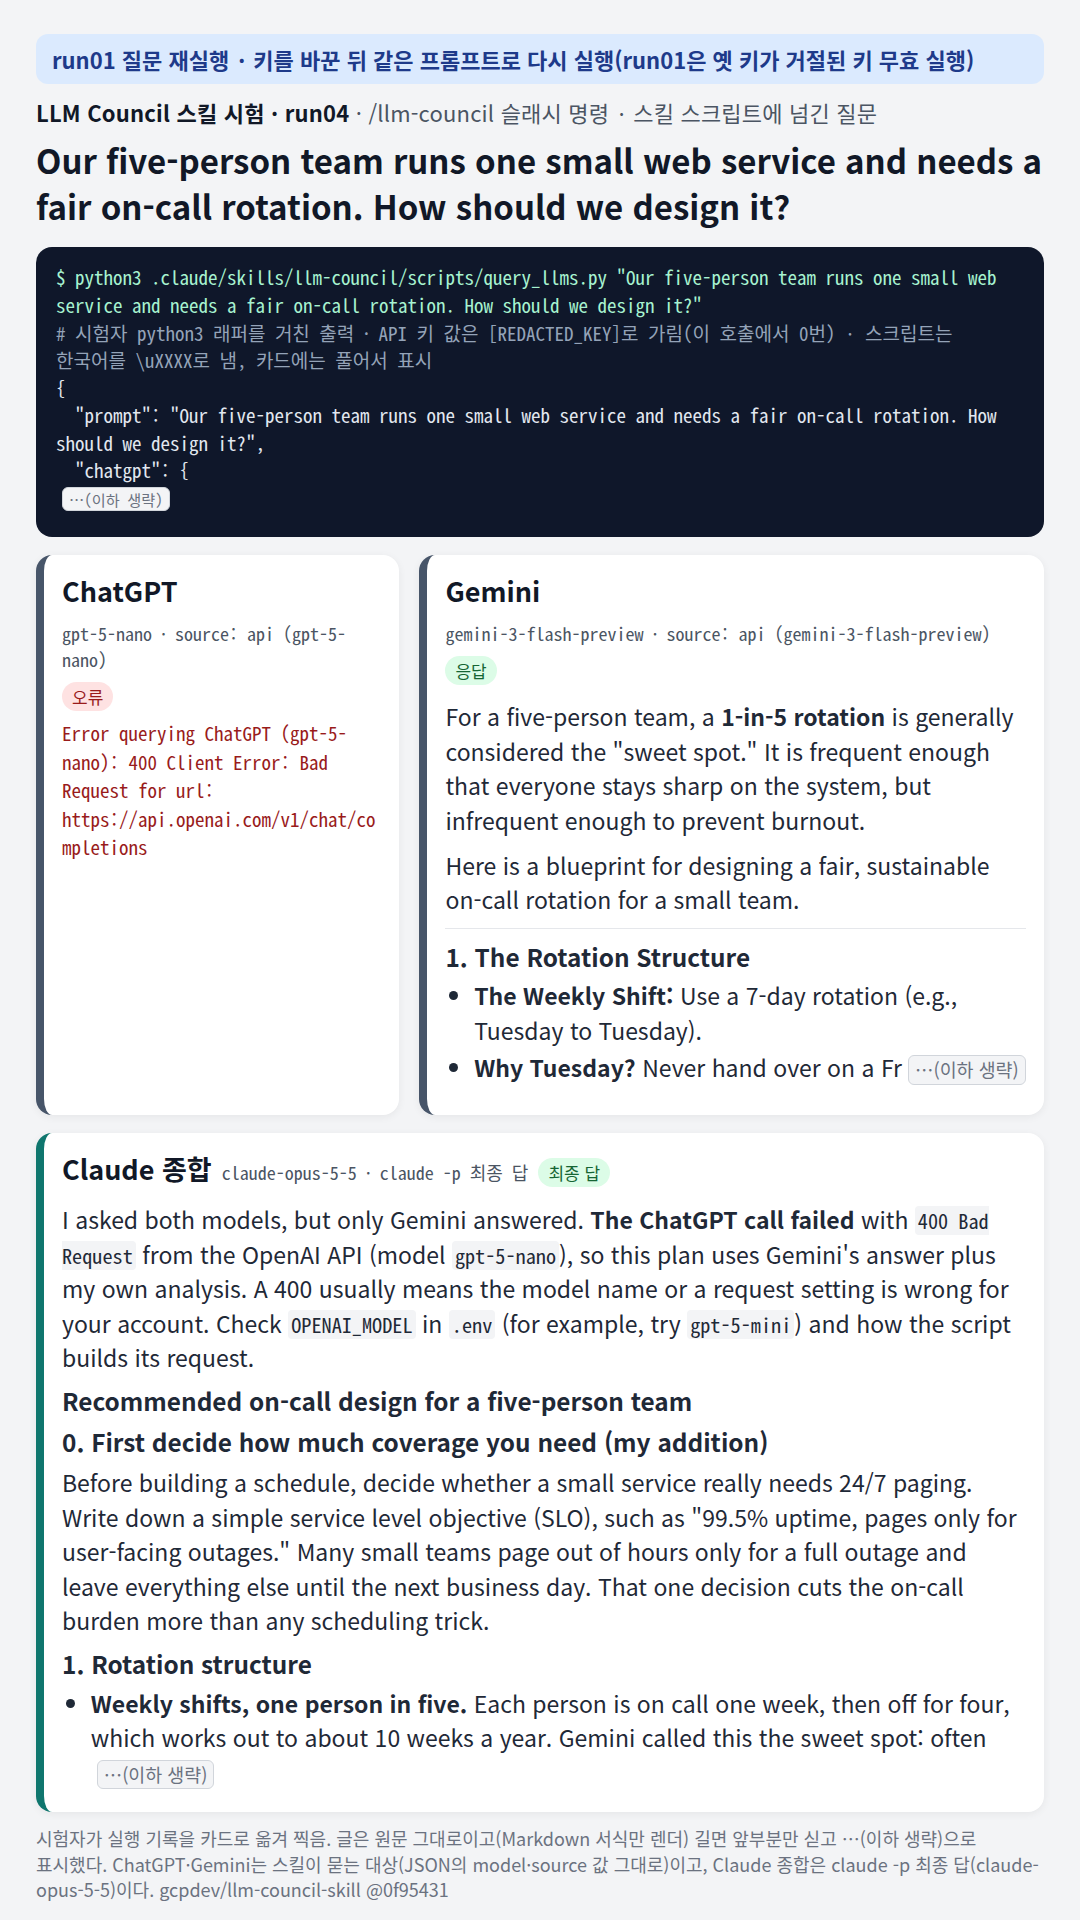
프롬프트 전문 보기
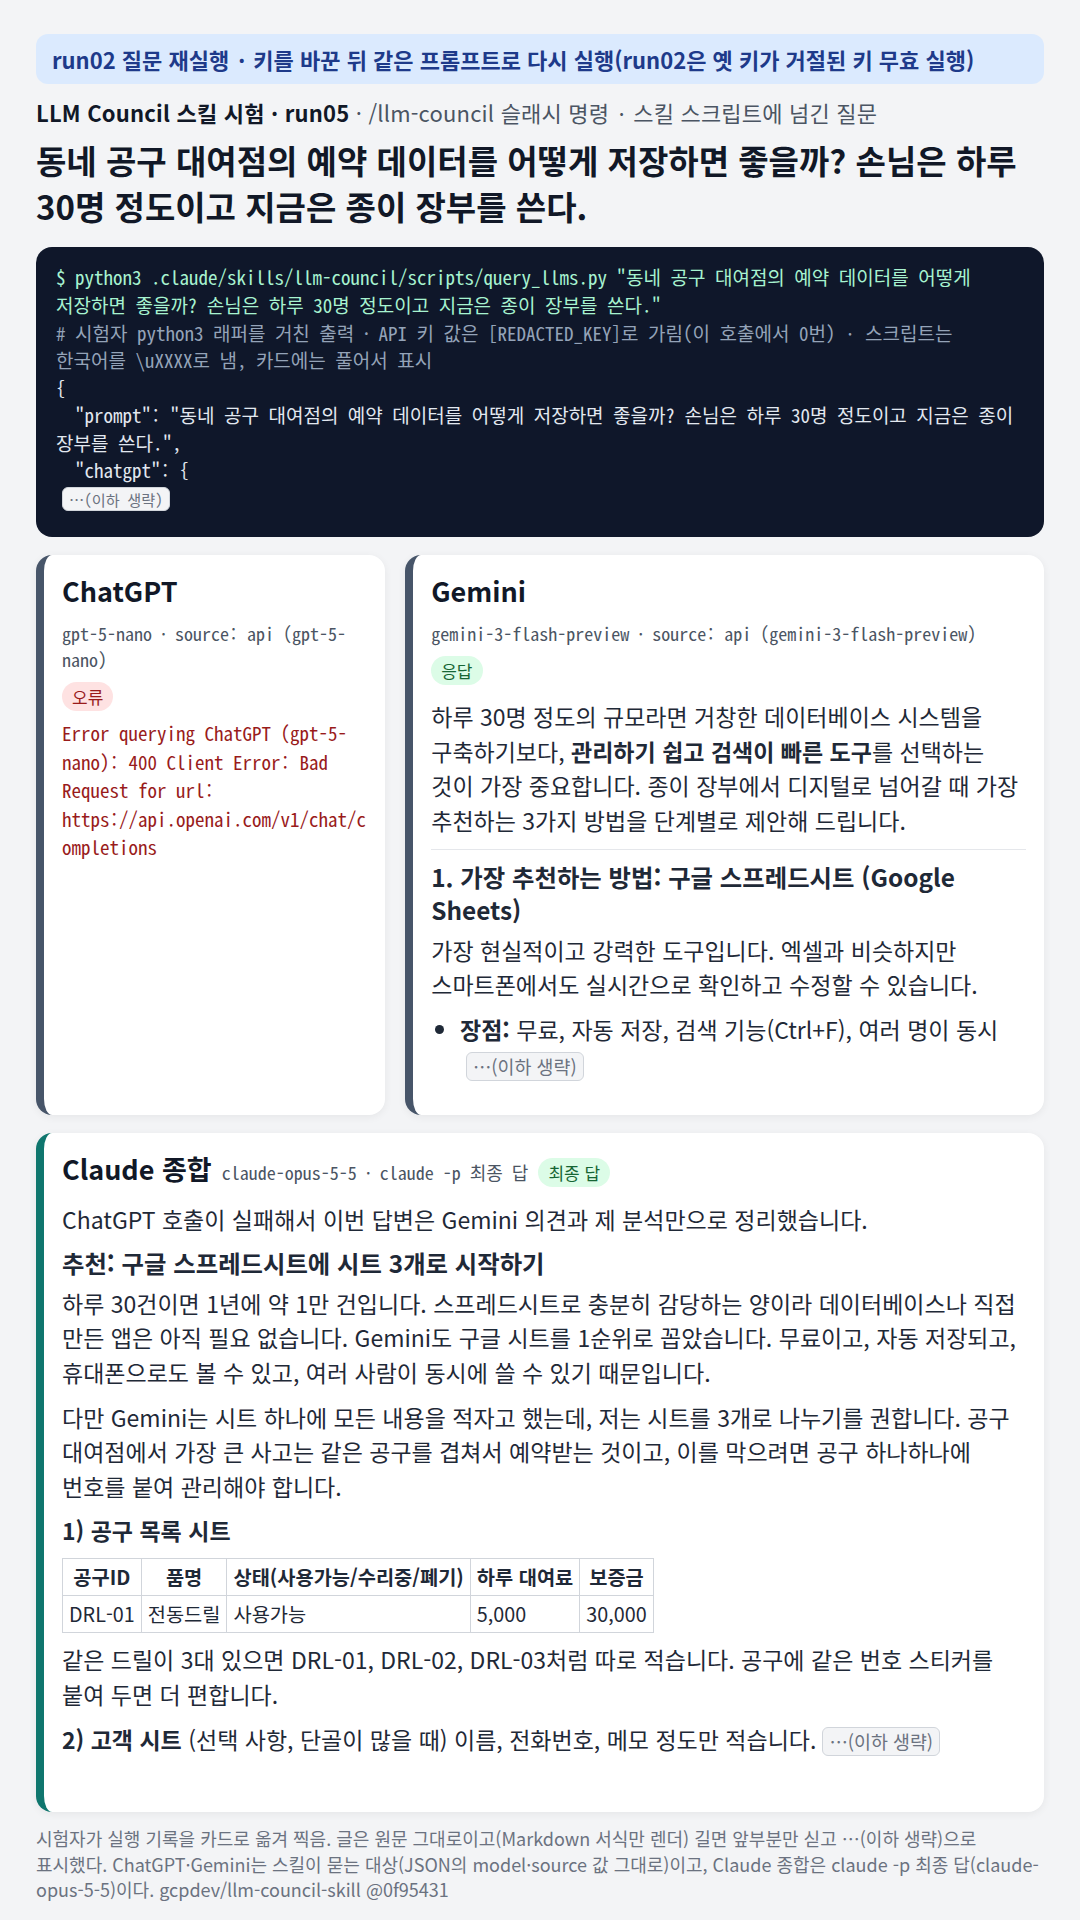
프롬프트 전문 보기
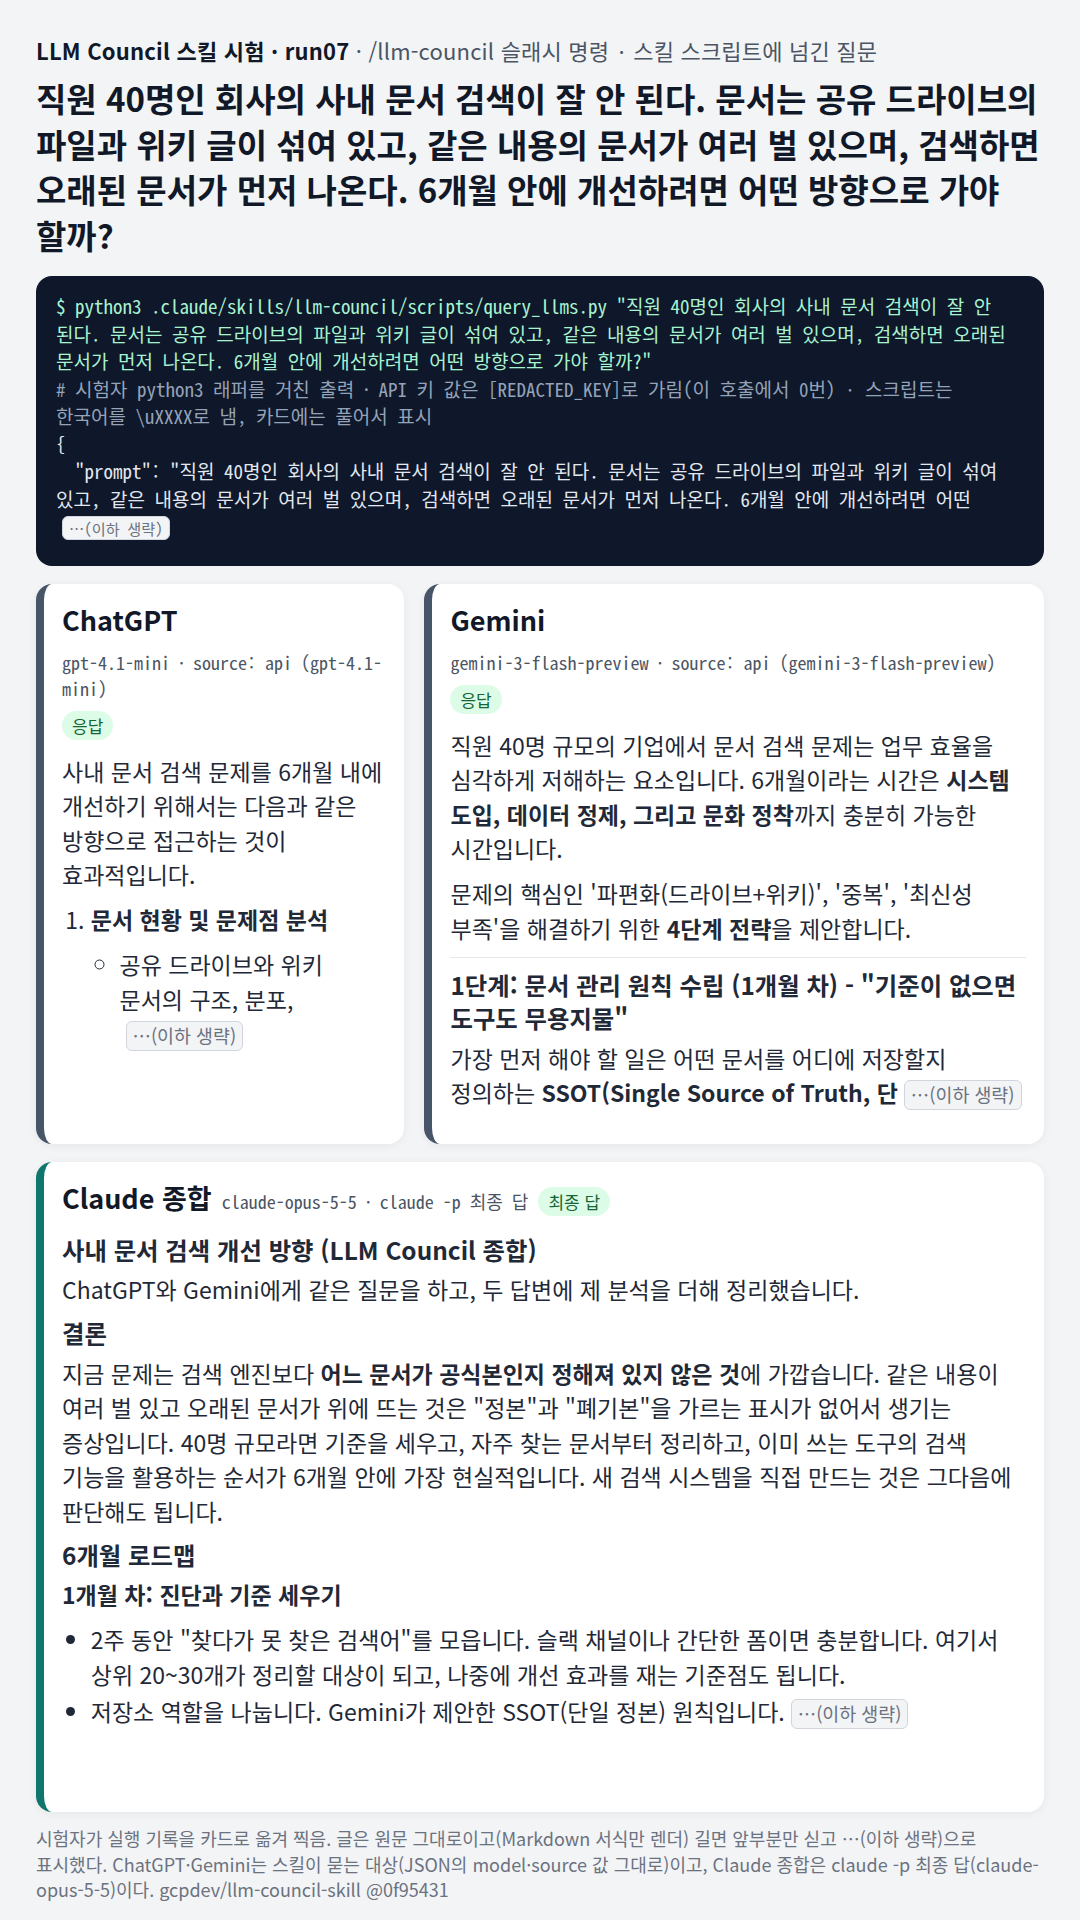
프롬프트 전문 보기
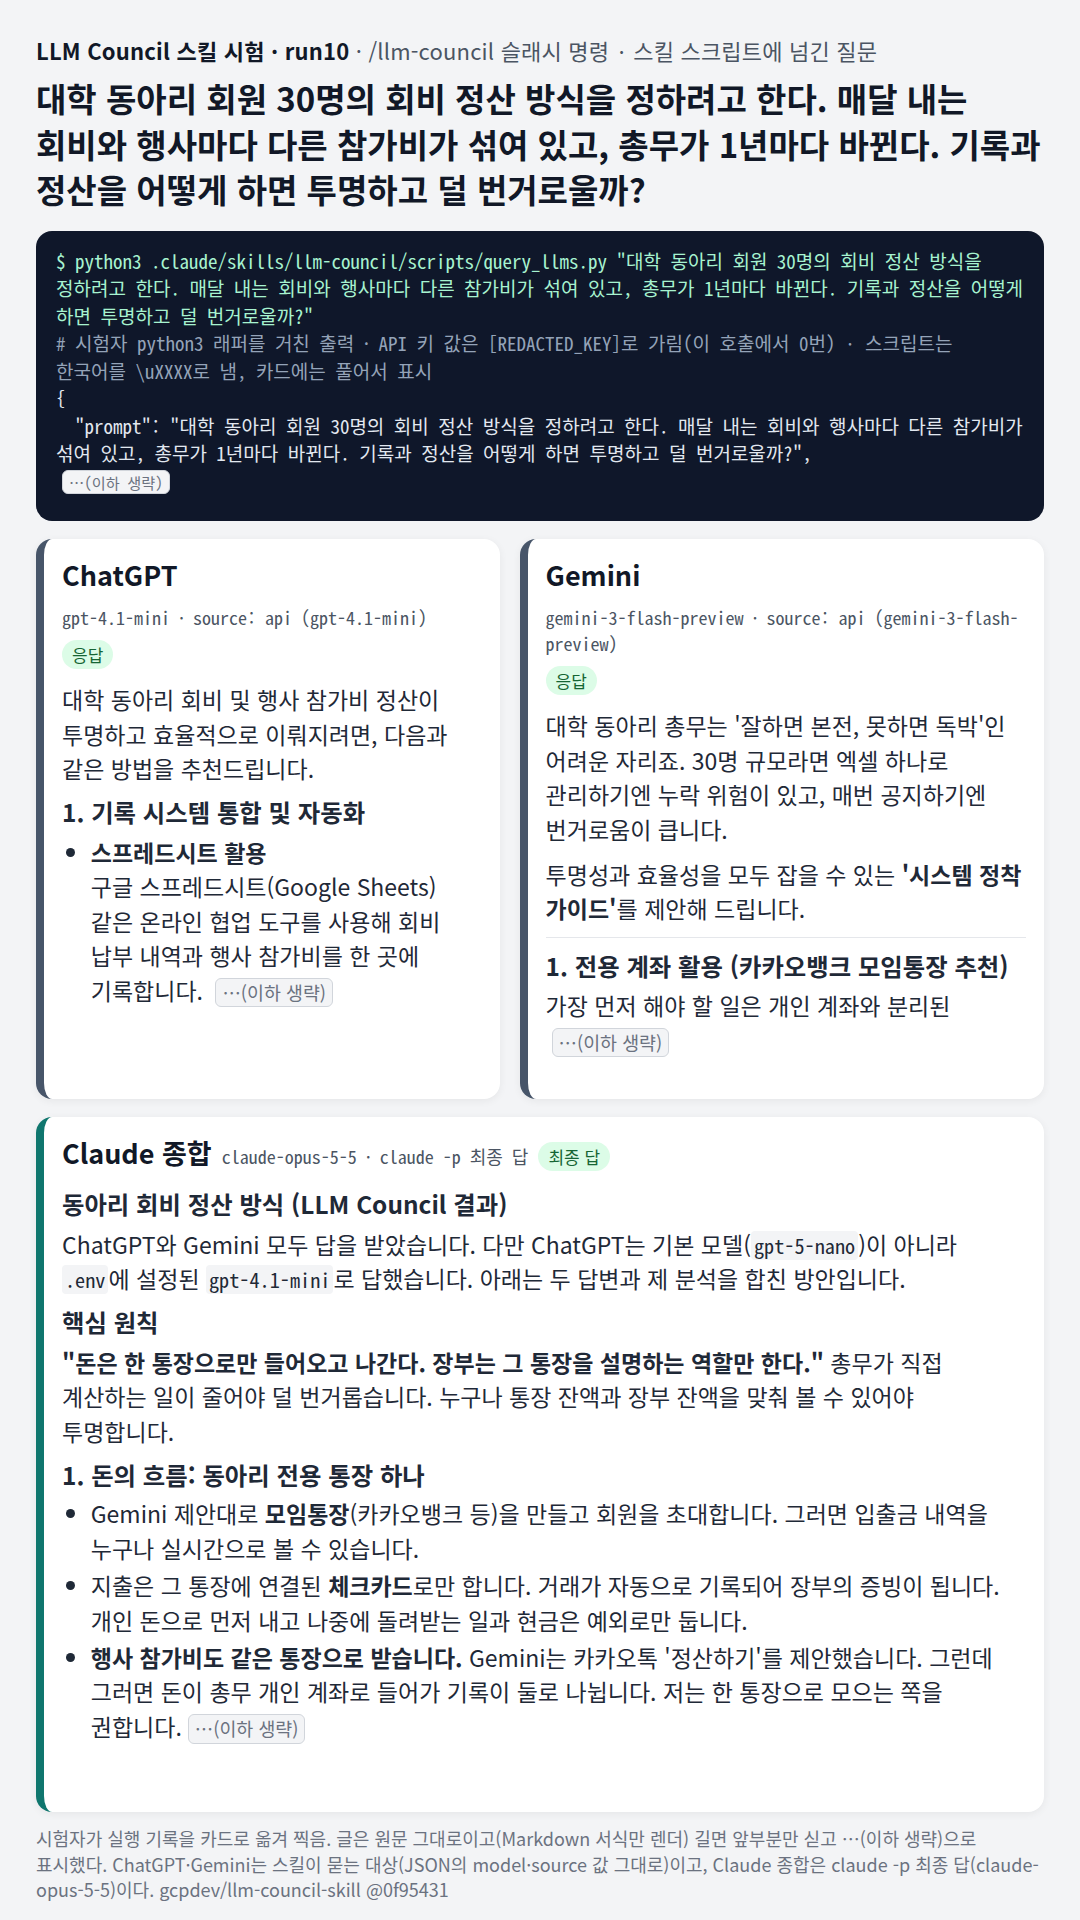
프롬프트 전문 보기
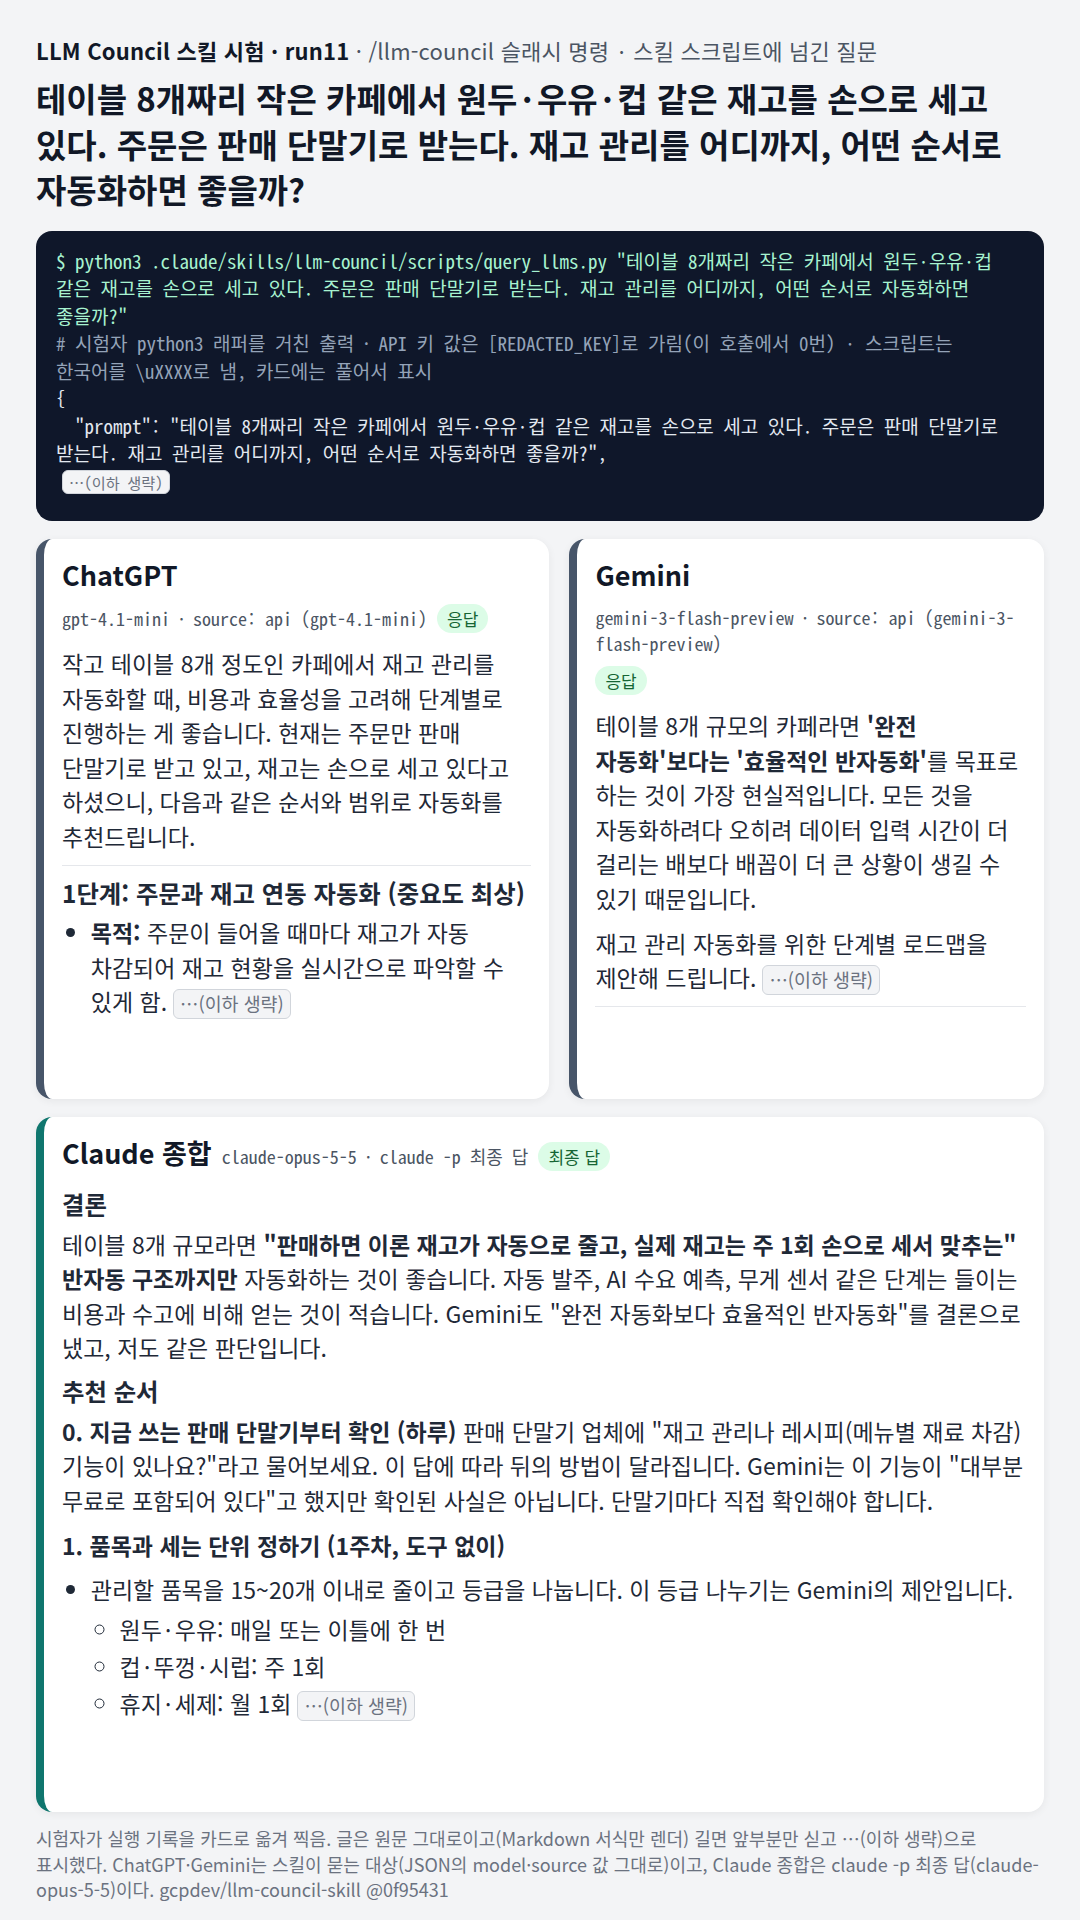
프롬프트 전문 보기
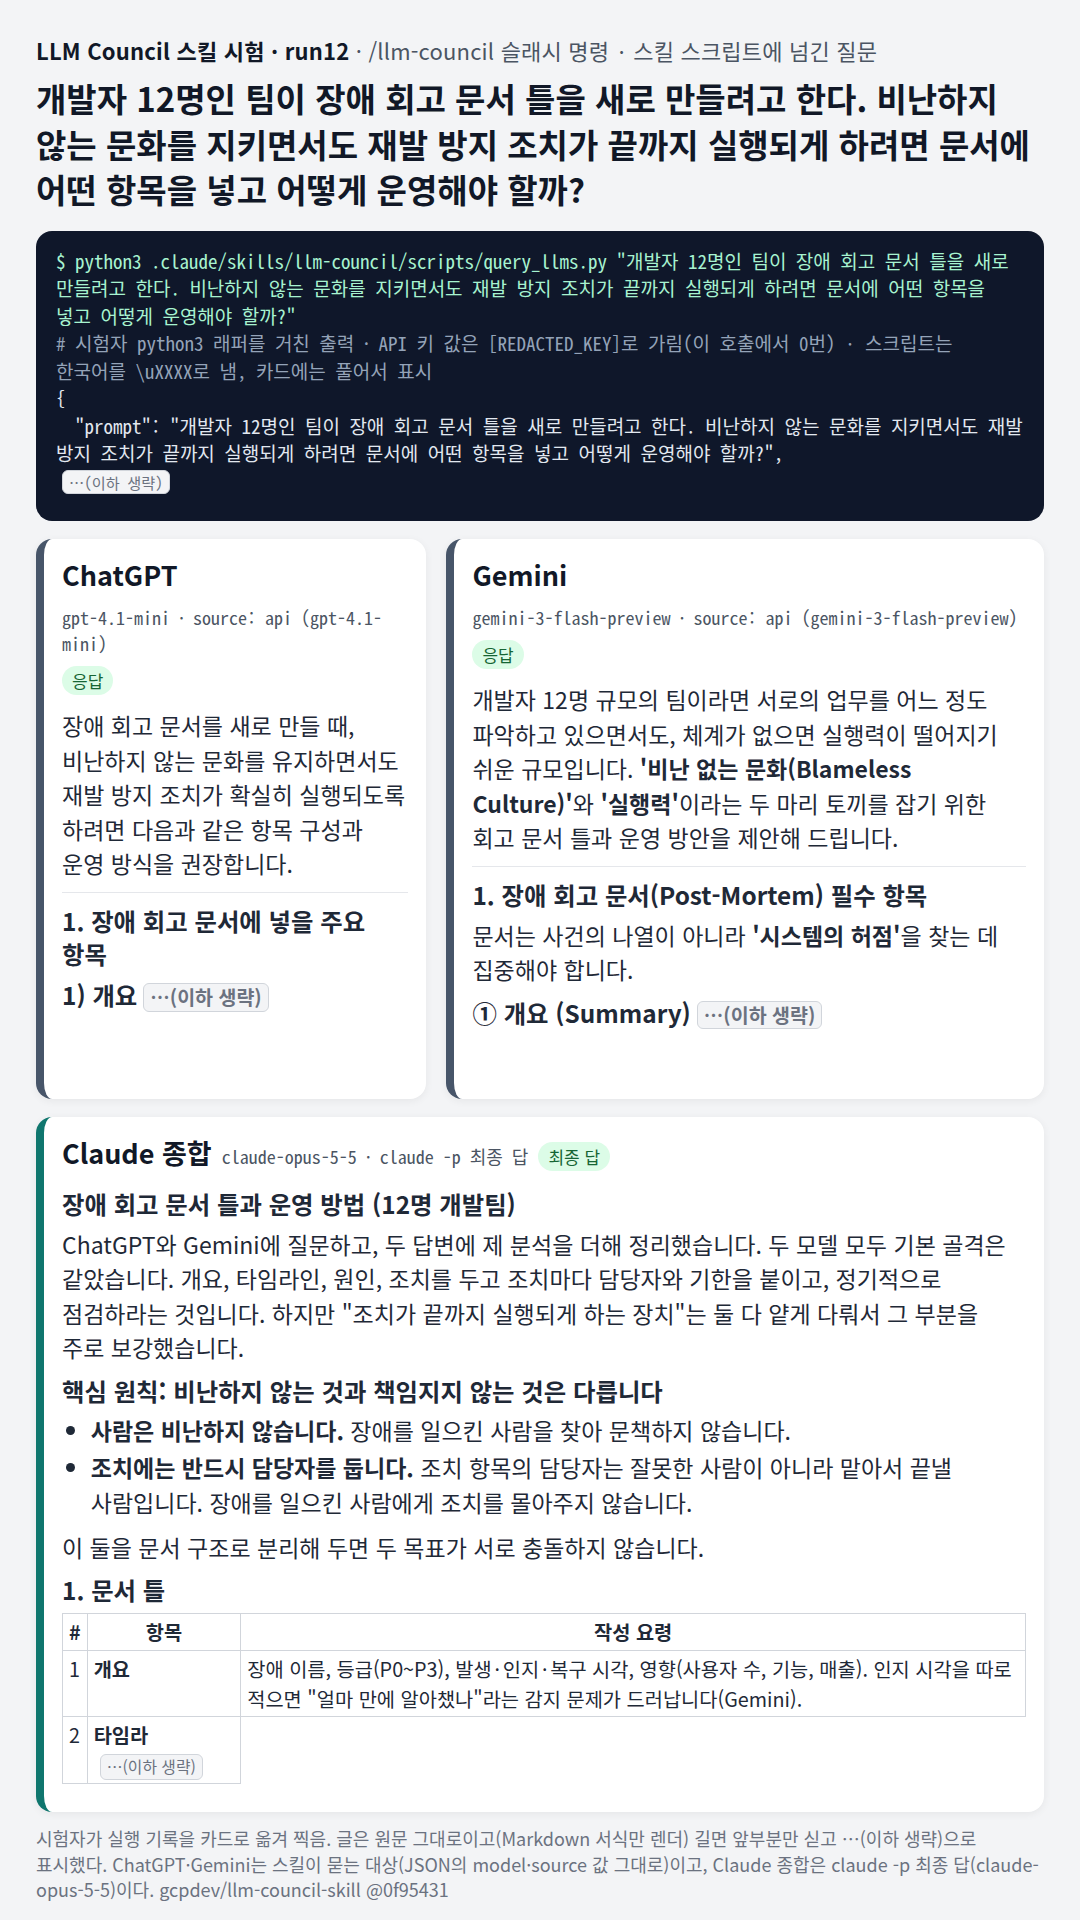
프롬프트 전문 보기
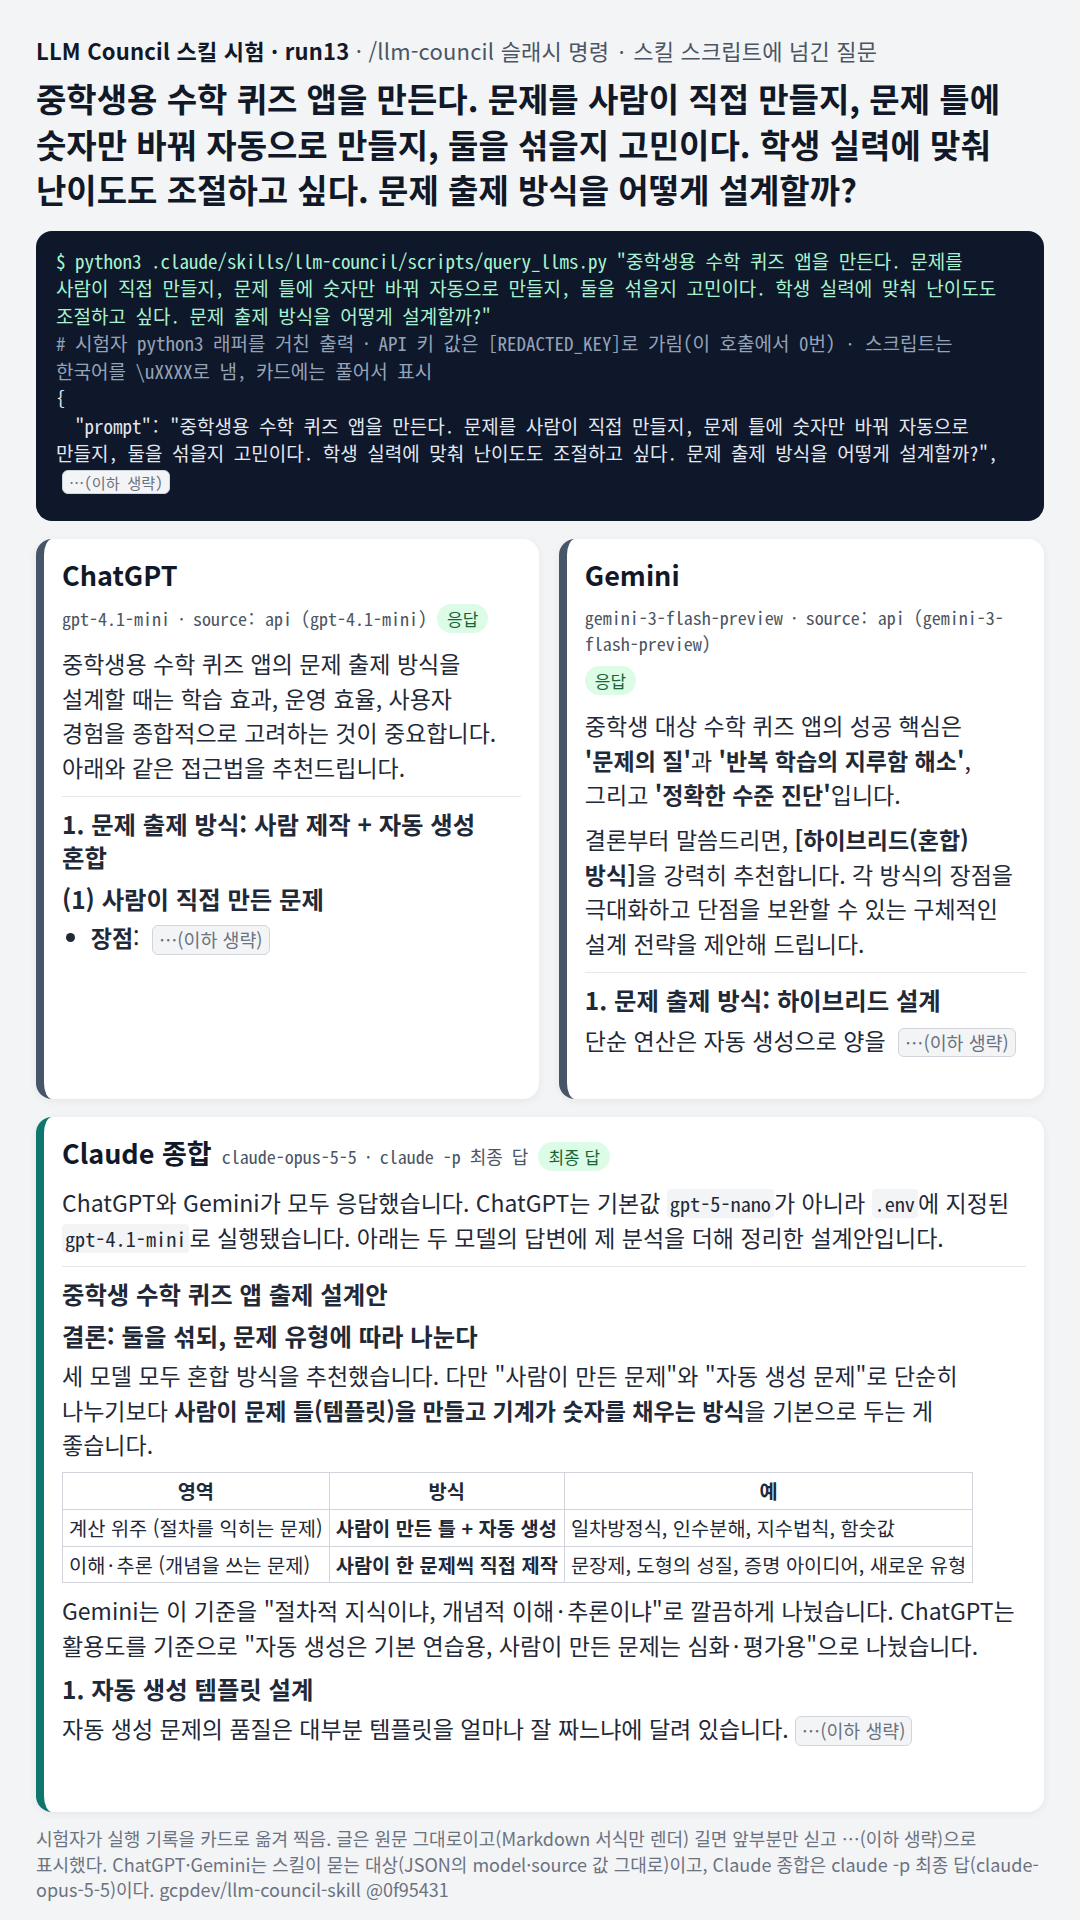
프롬프트 전문 보기
프롬프트 전문 보기
프롬프트 전문 보기
프롬프트 전문 보기